Diary
碎碎念、摸鱼与拾贝日志。
2025-7
2025-7-3
- CVE-2025-32462: sudo –host 提权。博客原文
sudo的 man 里有介绍--host参数的用途,基本上就是在使用-l查询当前用户的权限时,可以加一个--host xxx.com来查询在另一个 host 上的权限。没错,sudo是支持一个配置文件给多个主机的用户配置权限的。(我终于理解了为什么我机器上的sudo配置里,第二个字段都是神秘的ALL,原来是“在所有主机上”的意思)- 然而,
sudo的--help中却说--host可以和执行命令一起用,然后大家神奇地发现,这个居然能允许用户以“指定host”上自己的权限,在“当前host”上执行命令。这个漏洞完全让sudo的这套跨host功能变得完全没用了,因为用户现在可以以他拥有的最高权限在任意服务器上执行指令。
- CVE-2025-32463:sudo 在不加检查地 chroot 后,触发了 Name Service Switch(NSS)操作,导致攻击者可以构造恶意的 NSS 配置文件(/etc/nsswitch.conf)达成提权。博客原文
chroot实在是太危险了,尤其不能允许用户随意chroot到他具有任意写权限的目录下!利用时和配置文件劫持打组合拳有奇效。- 怀疑这些人每天就关注
sudo这种有 SUID 的 Binary 更新了什么新功能参数,然后研究它们有什么问题。
- 学习了 OpenC910 中的 AXI 总线接口,ARM IHI0022 手册 写得非常通俗易懂。
- 大致了解了下 Android 上的 BootLoader 锁和 ARMv8 安全启动的关系:
- BootLoader 锁(OEM锁)是厂商为了防止用户刷入非自家的镜像,在 recovery 模式程序中实现的一个“功能”。
- ARMv8 安全启动(Secure Boot)是一套标准,力求实现标准化的、基于密码学的信任链。ARM 官方提供了 Trusted Firmware-A (TF-A) 作为 ARMv8-A Secure Boot 的参考实现。(在 ARMv7 中不存在标准化的 Secure Boot,通常由厂商自行实现启动信任链,但也可以使用 TF-A 作为启动软件。)(在 ARMv8-M 中使用的是 Trusted Firmware-M)
- 搬到了张江,开启暑假打工生涯。住宿是老师在贝壳上租的,叫了保洁来帮忙清理,把屋子里的各种发霉的地方都清掉了。不得不说,虽然在房东和租客之间加上中介服务这一层抽象层会带来额外开销(服务费),但确实能给租客省下不少事。
2025-7-4
- 大致了解了下 Android 如何在 Linux Kernel 的基础上限制越狱:
- Android 4.3 版本开始,限制了
setgid/setuid系统调用,并启用了 SELinux。SELinux 是内核中的Linux Security Module (LSM) 框架的组成部分。LSM 在各种系统调用的函数入口处添加了安全钩子(security hooks),检查 SELinux 的策略(安全规则)来判断当前用户态程序是否具有合法权限。 - SELinux 的粒度比 Linux 原有的权限系统(用户、用户组)细很多,可以对同一个用户的不同进程做不同的权限设置,甚至可以对 root 用户(uid=0,gid=0)的进程做限制。这是通过在策略中将进程划分为不同的 type 完成的,比如在安卓上定义了以下这些 Type:app.te - platform/external/sepolicy - Git at Google。
- 在 Android 中,即使已经拿到了 root 用户权限,由于安卓自带 SELinux 策略的设置,也是残血的 root 用户。安卓源码中自带的 SELinux 策略会在编译成内核可加载的二进制格式后,集成到内核的 boot image 中或嵌入到 ramdisk 中,受到安全启动链的保护。Android 启动时,init 进程将查找并加载策略文件。
- 因此,Magisk 这种 ROOT 工具会在启动时对 SELinux 的策略进行 patch,见 awsome-magisk/重读Magisk内部实现细节.md at main · tcc0lin/awsome-magisk · GitHub。
- Android 4.3 版本开始,限制了
- 调整了博客的字体、字体大小和行距。字体设置参考了 博客字体设置方案 | Daniel’s Blog;字体大小设置为 15 px,行距设置为 2,更适合中文排版了(方块字比较密,行距应该设置得比英文大一些)。
- 看了 发现外星生命痕迹,确定度99.7%!——等等,这是怎么算出来的?,一篇关于统计学和概率的科普文。即使一项研究的确定度非常高,达到了5σ的黄金标准(置信度约为99.99994%),也有可能是受到干扰因素影响导致的结果,可能会被推翻。
- 把 OpenC910 的仿真跑通了,并且安装了 vcs、verdi、scl 工具,学会了用 verdi 看 vcs 仿真的波形。
- Vcs、Verdi 安装和使用参考 ubuntu 18.04 安装 vcs、verdi 2018、记一次VCS报错:/usr/bin/ld: undefined reference to
pthread_yield。但不得不说前面那个教程写得特么有点太烂了。验证服务器会跑在 27000 端口,需要确保这个端口可以访问。这篇教程写了如何配置防火墙规则开放 27000 端口,然后说“firewall 没有安装的需要用 apt 进行安装”——我都没有安装防火墙当然不用开放 27000 端口啊!
- Vcs、Verdi 安装和使用参考 ubuntu 18.04 安装 vcs、verdi 2018、记一次VCS报错:/usr/bin/ld: undefined reference to
2025-7-5
- 在外面演出,上午随便找了家店洗吹,下午彩排和演出,晚上聚餐。
2025-7-6
- CVE-2025-33053:一个恶意的
.url文件(Windows 上的 InternetShortcut)可以通过指定WorkingDirectory字段为一个远程的文件服务器路径,使应用加载恶意的 dll 甚至 exe。- 这个漏洞和 CVE-2025-32463 非常相似,我觉得都可以称为“路径劫持”类漏洞,不过它们的根因不太一样。
- 在 Linux 上许多系统框架都会根据绝对路径找配置文件,把这些路径直接硬编码到代码中,并且在
man手册中进行说明;攻击者可以chroot就意味着他可以控制根目录位置,进而控制这些配置文件。 - 而在 Windows 上,这里利用的是系统查找可执行文件/动态链接库的顺序;攻击者可以控制工作目录就意味着他可以劫持 DLL、甚至劫持可执行文件(也就是这个 CVE 的利用手法,攻击者的
.url文件中直接指向的iediagcmd.exe会使用系统 API 调用route.exe print,触发远程服务器上的恶意route.exe调用)。 - 关于 DLL 劫持网上已经有很多写得非常好的资料了,像 CVE-2025-33053 这样的漏洞感觉已经研究地非常充分了:DLL劫持漏洞 | Yang Hao’s blog、Automating DLL Hijack Discovery. A dive into Windows DLLs, DLL… | by Justin Bui | Posts By SpecterOps Team Members。
- 看 有知有行投资第一课。
- 钱本身不是财富,货币本质上是用来交换的中间物,由于其通用性也常被大家伙当作衡量财富的标准。如果以货币量衡量,现代人类社会的财富一直在不断地增长,然而不能仅仅凭借货币量来衡量人类社会的财富——货币背后的资源、产品、服务才是最重要的。
- 如果我们以资源、产品、服务这些实际价值来衡量的话,大多数人也会认同现代(包括近现代)是一个所谓财富大跃迁的时代,科学的进步、工业化、信息化大大增长了财富增加的速度。在这种背景下,我等一般人能够通过投资来赚钱才成为一种可能的事。否则就是经济学家的那个笑话了:看到地上有十块钱不捡,因为如果有赚钱的机会话,前人一定已经赚过了。在总量不变的情况下有赚必有亏,而亏的大概率是我等没什么知识的普通人。当然,也有人认为现代财富增长的速度并没有那么快——许多我们以为的价值可能只不过是吹出来的泡沫。
- 不管怎么说,在创造财富的过程中,很大一部分的财富是以公司(具体来说,现代股份制公司)的形式生产和创造出来的。从荷兰的东印度公司(1602 年)开始,公司就开始通过售卖自己的股权来筹集资金,而股东则可以享受公司的分红。一个公司的股价是随着市场波动变化的——投资者既按照自己对公司价值的预期(即公司给他回报的分红多少)而购入他的股票,也可以根据市场对公司价值的预期而选择购入或抛出股票(即赚其他投资人的钱)。
- 下午去了前滩太古里的茑屋书店。太古里的装修和建筑真是太漂亮了,感觉像来到了东京。茑屋书店人很多,很大一片地方,书的质量属于还不错,买了本特德姜的小说集。
- 晚上六星小聚,四个 pwn 猫齐聚一堂(还有一个外包手),讨论二进制的灰暗未来。绕着徐家汇散步散了挺久的,算是一起锻炼身体了。
2025-7-7
- 看完了《摇滚乃是淑女的爱好》,看到最后主角乐队薄纱了现充乐队,用执着的东西打败了浅薄的东西,还是挺感动的。
- 学习了 Linux 的 Buddy 内存管理机制,现在终于看得懂了。
- 继续学习 OpenC910 中的 smart_run SoC,基本搞懂了总线互联的拓扑,原来 SRAM 才是主角。
- 更新了博客的 友链界面,现在可以自动parse YAML格式的数据变成友链卡片了。
2025-7-8
- 学习了 Single Error Correcting 和 Double Error Detecting Code 的原理,当年的图灵奖,太天才了。
- 继续看论文《Rubicon: Precise Microarchitectural Attacks with Page-Granular Massaging》。
- 参考 Linux Kernel Exploitation - Setup | r1ru 配好了简单的 Linux 内核调试环境。下一步准备把 Buddy System 里的一些关键的结构体和函数搞清楚,然后来自己复现下 Rubicon。
- 我在 busybox 的编译选项里打开了 telnetd、tar 支持 gz。我用 musl-gcc 编译好静态的程序之后,用 PWN Cheatsheet - HackMD 这里的脚本把它压缩成
.tar.gz后用base64慢慢发上去,然后解码再解压成原来的程序。搞这么复杂都是因为 busybox 不带 sshd(不能 scp 了),且我的qemu-system-x86_64是系统包管理器安装的,不支持虚拟文件系统(不能直接共享目录了),有点蠢。 - 内核启动选项中(
qemu -append后面跟着的就是内核启动选项)记得要加一个nokaslr,不然gdb加载了符号文件之后也还是会一脸懵逼的。 - 在 qemu 里可以用户态和内核态使用同一个 gdb 实例来调试,只需要把编译好的用户态文件的符号告诉 gdb 就可以下断点调试用户程序了。具体步骤是首先需要提前在用户态文件的编译选项中加上
-fno-pie以禁用 ASLR,然后objdump -S看看代码段(.text)的加载位置(比如0x401020),最后在 gdb 当中使用add-symbole-file <elf> -s .text <addr>加载符号信息。不知道为什么 gdb 好像并不能直接正确识别 ELF 文件的地址,所以才需要按照这样手动加载一个段进去。如果需要加载其他段的话直接在后面 append 就可以,比如-s .text 0x401020 -s .init 0x401000。
- 我在 busybox 的编译选项里打开了 telnetd、tar 支持 gz。我用 musl-gcc 编译好静态的程序之后,用 PWN Cheatsheet - HackMD 这里的脚本把它压缩成
2025-7-9
- 给博客加了简单的搜索功能,不过现在还没有支持搜索日记内容。
- 用的是 Algolia 的服务,需要先注册账号,然后把博客内容上传到自己的数据库中,最后在博客的前端中实现一个搜索框,向 Algolia 后端发送请求。
- 将博客内容上传到服务器可以使用 GitHub - algolia/jekyll-algolia: Add fast and relevant search to your Jekyll site 这个插件(别的静态网页生成框架应该也有类似的插件可以用),虽然已经停止维护了,但 jekyll 本身并不经常大更新所以这个插件现在和未来一段时间应该还是可用的。插件的官方文档和教程已经挂了,可以访问 Algolia for Jekyll | Add fast and relevant search to your Jekyll site 这个网友自己搭的镜像站阅读。
- 集成到前端中还是比较繁琐的,我拜托 claude 帮我写了一下,简单用用还是足够的。
- 继续学习 OpenC 910 中的 smart_run SoC。发现了 玄铁处理器的Linux移植 这个系列博客,是母校智能体系架构与开源芯片实验室的,实在是太有技术了,目前只看了第一章,后面技术细节太丰富了有机会再看吧。
- 读了 关于财务自由若干问题的实践与思考 - 纯牛马的救赎,觉得作者对财务自由的理解还是很有启发性的。作者追求的财富自由并不仅仅是财富,而是建立在对自己的了解基础上的、一种自己适合和喜欢的生活状态,或者说是一种逐渐探索志趣,逐渐探索自在愉悦的生活方式。作者关于开源节流两方面的论述也挺有道理的。
- 基于 GitHub - allejo/jekyll-toc: A GitHub Pages compatible Table of Contents generator without a plugin or JavaScript :octocat: 给博客文章加了目录。前端也是靠 Claude 写的,我爱 AI。
2025-7-10
- 看完了《Rubicon》,借助 AI 学习了一点点 Buddy System 的代码。AI 用作解读代码还是不错的👍。
- 今天是生日,白天摸鱼,晚上和大学好哥们一起去金虹桥吃了非常うまい的炸猪排(静冈胜政日式猪排)。
2025-7-11
- 把要设计的加密模块的功能和流程拆分了一下,分出了几个子模块来。似乎设计整个模块也不像想象中的那么难了。
- 继续看 Buddy System 源码,感觉内核这种项目也不是很恐怖了,毕竟也是人类维护的。网上相关的代码解读还挺多的,比如 Memory Management | What is the Utopian World!、3.2.4 Buddy System(伙伴系统) | Linux核心概念详解,不过我感觉在了解了大致的机制以后自己结合 AI 看源码比阅读这些写好的博客要好,理解速度更快,而且可以自己发掘感兴趣的细节。
- 搭了一个简单的 Folo Webhook to Telegram 服务,可以收集安全新闻和博客推送了。
- 发现 《东方幼灵梦》 和 《东方灵灵梦》 都有人做了高清重置版,看了一集就又眼泪水哒哒滴了😢
2025-7-12
- 学习 Linux 音频软件栈,看到这篇博客讲得还可以(有的地方讲得很浅,在 AI 辅助之下阅读会好一些):Making Sense of The Audio Stack On Unix。但是还是没有搞懂为什么我的 Thinkpad X1C gen13 Fedora 没办法正常使用耳机,我已经使用了最新的内核和 SoF 固件版本了。
- 乐队排练,晚上在日月光吃了平成屋,算是还不错吧。
2025-7-13
- 继续研究为什么笔记本 Linux 没办法用耳机,失败。一直以来俺的理想都是理解计算机这个黑盒在背后是如何工作的。现在在以 Linux 为契机学习音频系统的时候,真的有感觉到抽象层的伟大,将无数复杂的细节都隐藏了起来。物理的声卡提供了各种配置寄存器,在固件驱动下,变成 Linux 内核音频模块 ALSA 所提供的抽象的声卡接口。在用户空间,各种声音服务器(PulseAudio、PipeWure)又基于 ALSA 提供的接口,为 Linux 桌面提供了统一管理的功能。应用开发者只需要基于一些接口库,向这些音频服务器发赛音频,就可以简单地完成音频播放的功能。这其中有着一般路人难以想象的工程量,也因此我不得不佩服程序员们合作的力量。但我还是不知道我的耳机为什么不能用,感觉是固件的问题。
- 昨天和今天一通乱搞把 PulseAudio 搞爆炸了,还好按照 reddit上的教程 修好了。Average Linux User…
2025-7-14~15
- 和溴化锂一起装了台机。
- 推进项目:把各个模块的输入输出规划了一下。
- 感冒了,无法干活。
2025-7-16
- 调 Rubicon。
- 去参加了 RISC-V 中国峰会的一个付费教程(200 元你敢信),了解了一下 CHERI、CHERIoT 以及 scisemi 这家公司基于 CHERIoT 搞的一套软件栈。体验了一下基于他的 cheriot-rtos 和 SDK 开发 C/C++ 嵌入式应用,其实还挺简单有趣的。希望他们以后能搞出点实际的东西(据说是即将要有实际的 CHERI 核了,支持一些常用的嵌入式接口),不要浪费了我的 200 元。
2025-7-17
- 依然生病中。
2025-7-18
- 在 RISC-V 中国峰会的各个场之间来回窜,把和安全相关的都听了下。目前的 RISC-V 的 TEE 还在推进生态的过程中,标准和技术都还在不断更新,比如 smmtt 还刚刚出了一个新版(指今年二月更新了 v0.3.0)。
- 有人在把 OPTEE 迁移到 RISC-V 上以支持 GP 标准的 TA(SiFive、芯来 Nuclei),有人在基于 CoVE 标准开发 TEE 架构(玄铁),Intel 在将他们的 x86 IoT 场景 hypervisor ACRN™ 迁移到 RISC-V CoVE 上(acrn-riscv)。当然还有知名的 Penglai,可惜时间冲突了没去听夏老师的分享。
- 对于开发者和厂商来说,选项还挺多的;不过对于我们搞安全的来说,部署到什么系统上才是重点,毕竟攻击需要考虑攻击的收益。目前看来,RISC-V 的 TEE 并没有部署到什么现实中的应用上。但是我们可以简单估计一下它们的使用场景,其中嵌入式、健康计算、车控会比较多,其次是 AI、云计算领域。
- 尽管 RISC-V 目前主要推动的是 AI 主题,但我觉得 AI 的攻击面相比传统安全要少得多,TEE 用来保护 AI 目前来看更多还是噱头作用。而在云计算这块,或者说整个桌面和服务器领域,RISC-V 距离赶上 x86 差得不是一星半点,就不提了。下面这张图是今天超睿科技展示的“世界上第一颗桌面级 RISC-V CPU”:
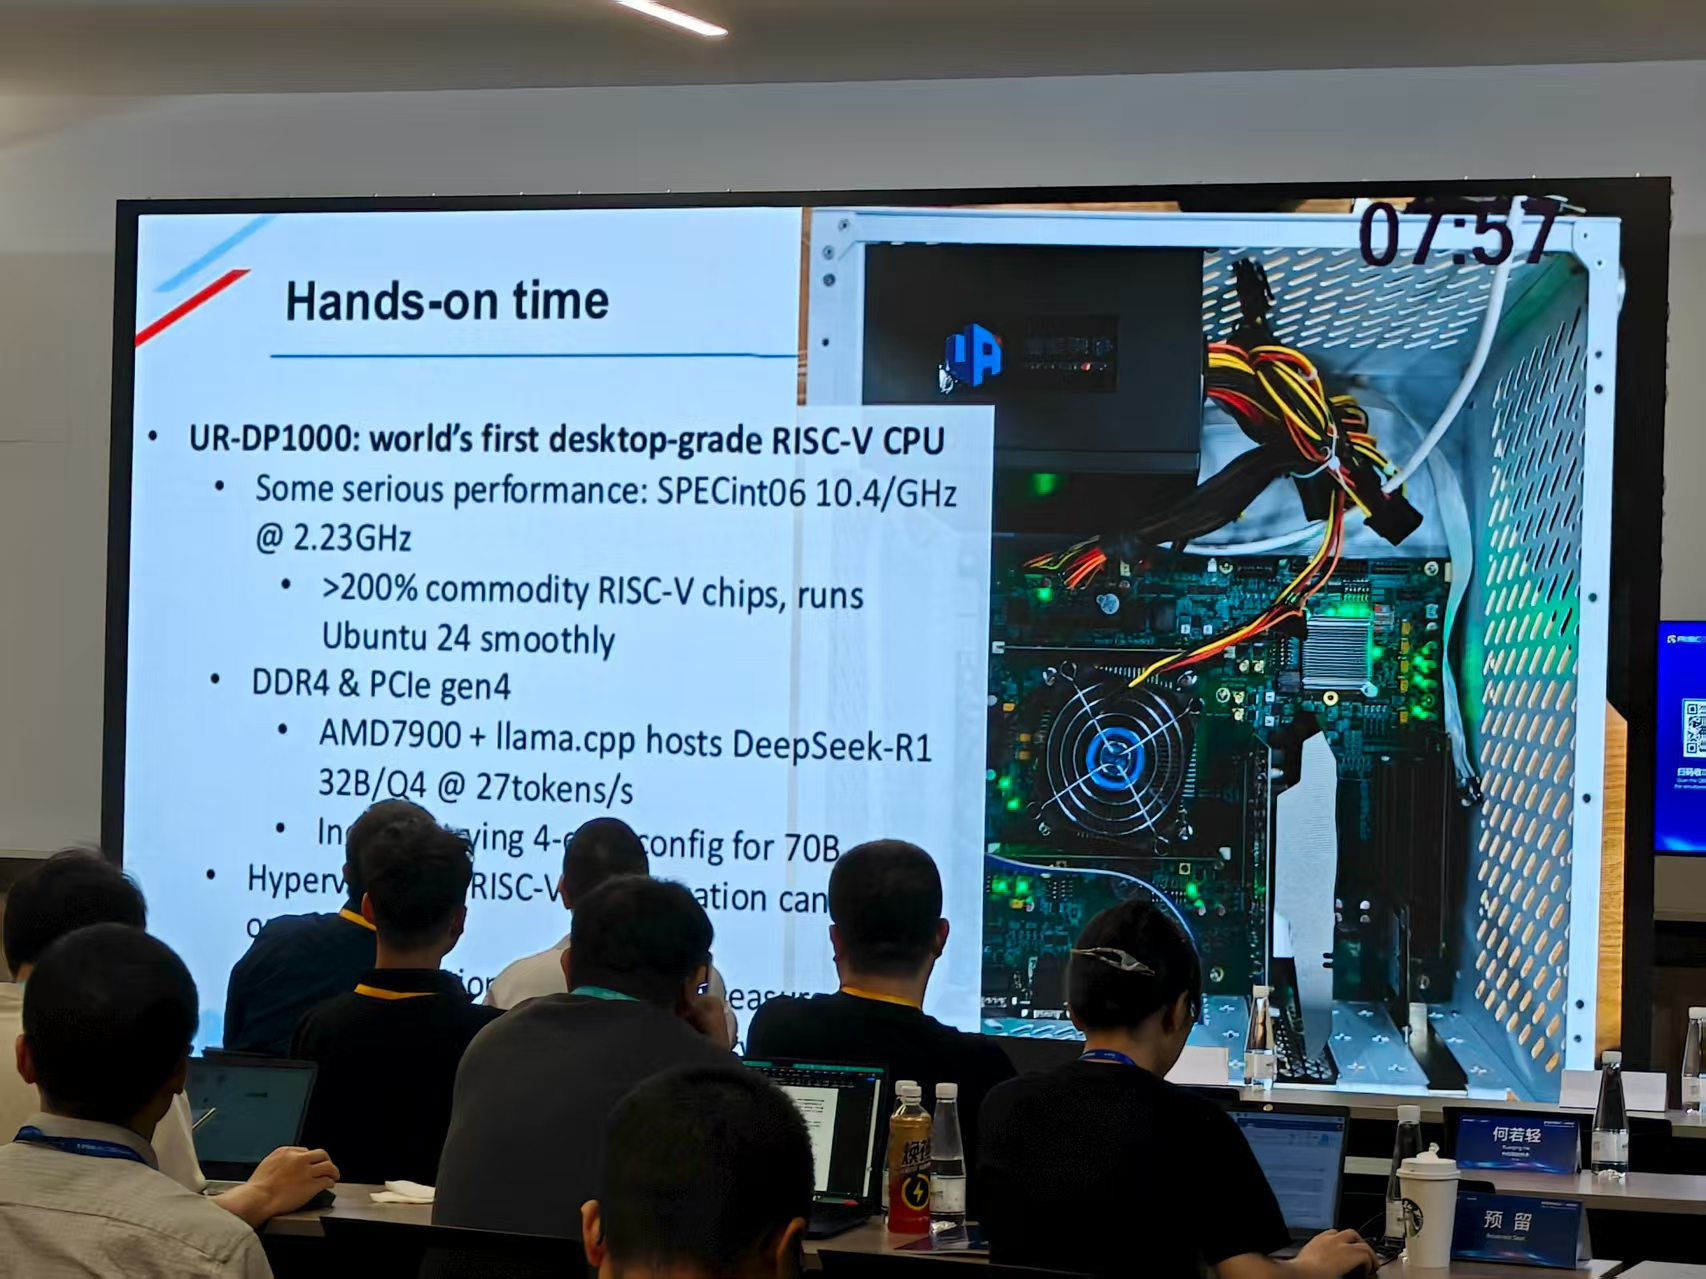 难道真的要赶上 x86 了吗!在交大 tcloud 实验室的校友对这颗 CPU 做的 评测 中提到,UR-DP1000单核性能达到了SPECInt2006 10.4/GHz 和 SPECfp2006 12.0/GHz 的水平,ChatGPT 说这个成绩属于极高的水平,远远超出大多数普通桌面处理器(即便是许多高端消费者级处理器)。可惜,主频只有 2.23GHz 的话,乘上去之后还是离现在的 x86 桌面处理器有差距啊!
- 也有厂商在搞安全协处理器(CryptoManager RT-6xx Root of Trust | Security IP - Rambus)把安全攸关的任务交给协处理器完成,类似把矩阵计算交给 NPU 或者 GPU。不过这种架构也有天生的弱点,我们知道“一条链的强度取决于其最为脆弱的一环”,在安全协处理器的场景下,这一环就会变成 CPU 本身以及其与安全协处理器通信的链路。
- 巴别塔圣歌真好玩。SHENZHEN I/O 太好玩了。
2025-7-19
- 学习 OP-TEE。里面一个很重要的概念是 Hardware Unique Key,OPTEE 的 Secure storage 子系统会基于这个硬件密钥派生加密文件用的密钥。这个 HUK 需要是一个固定的值(不然就没法解密之前加密的文件了),并且“in the best case the HUK should never ever be readable directly from software, not even from the secure side”。但和这句英文可能冲突的是,对 OPTEE 进行适配的厂商需要自己实现
tee_otp_get_hw_unique_key函数,允许 OPTEE 与他的硬件交互获取 HUK;按照这句英文的说法,厂商的最佳做法应该是:只允许硬件提供一个密钥派生接口,而不允许任何方式拿到 HUK 本身。总之这是一个重要的 asset,在评估 OPTEE 安全性的时候需要重点考虑。 - 跟随 Dr.604 学习了快速手工扒谱的技术。
- 和室友聊天,他实习的 leader 是 Atum。听说 Atum 正在推进三件事:学习投资(这样就不用担心失业)、成为行业大佬(这样就不用担心失业)和强健身体(这样失业了可以回家送外卖)。我非常认同这个想法,希望我也能推进好这几件事!
2025-7-20~21
- 玩 shenzhen I/O,成果见 【Shenzhen I/O】まにまに(使用汇编语言实现)_哔哩哔哩_bilibili
- 继续看《The Hardware Hacking Handbook》
2025-7-22
- 又和溴化锂和 LoboQ1ng 和 M1aoo0bin 装了台机。
- 继续复现 Rubicon(都这么多天了,疑似效率有点太低了),发现 block merge 这一部分作者根本都没在代码里实现… 哥们有点太偷懒了!
- 读了 安全隔区 - 官方 Apple 支持 (中国),是《Apple 平台安全保护》的一章。发现基于完整性树的内存完整性保护在现在的苹果设备当中还是非常广泛地部署了的,于是为自己的内存加密项目感到欣慰。有空可以找一些逆向分析苹果设备安全机制的论文看看,有点感兴趣。
- 学习了 arch 上打软件包的方法,学会把 AUR 上的仓库 clone 下来自己改改安装了。
2025-7-23
- 给 Rubicon 作者发了邮件,发现 block merge 不是没有实现,错怪了 orz。大哥回邮件回得巨快,而且非常详细,弄明白了很多地方。大哥推荐我在真机上复现试试,qemu 里的环境可能差异比较多;还说之前的学生在一周内就复现成功了,鼓励我也试试,给大哥跪了!
2025-7-24
- 推进内存加密课题,感到压力山大。
2025-7-25
- 学习数字设计知识。以前一直看不懂 CMOS 管和逻辑门有什么关系,现在终于有点搞明白了。另外,理解了 FPGA 和 ASIC 的区别:ASIC(Application Specific Integrated Circuit)是专用于某个任务的芯片,而 FPGA 是通用的可编程集成电路。
- 我们通常接触的 CPU 等芯片都是 ASIC,这是因为这些芯片会大量地出售到消费市场中,实现 ASIC 后单个芯片的成本比 FPGA 低;另外也有性能上的考虑,ASIC 可以达到 FPGA 所无法达到的性能。
- 但是,ASIC 的流片设计需要极大的成本,而 FPGA 则不需要。因此,只有在需要大量量产(且 ASIC 量产节省的成本大于 ASIC 引入的额外单次设计成本),或者是需要 FPGA 所无法达到的性能时,才会去考虑 ASIC;否则 FPGA 是足够好的。
- 上周在浦东图书馆看到一本书叫《宇航高可靠 FPGA 设计技巧》,当时想问为什么宇航用的是 FPGA 而不是专门设计的芯片,现在懂为什么了。(因为此类芯片不会大量量产)
- 向导师要了 Intel CPU 搭配 DDR4 内存条的设备,可以用来复现 Rubicon 和 Blacksmith。
2025-7-26
- 把 pwn.college 很久以前卡的一关打通了,依靠 Discord 的帮助。
- 在 UIUCTF 2025 做了一道逆向:Damaged SoC。
- 题目基于作者自制的流水线 MIPS CPU,给出了一个基于 verilator 的 stripped 二进制文件,用来运行 CPU。所以这是一道 VM 类型的题目(大雾)。内存模块使用
$readmemh("memory.mem", data_seg)加载了十六进制文件作为内存数据,题目也给出了这个文件作为附件。 - 将
memory.mem转换成二进制文件后,就可以用 IDA 加载了,但需要手动选择一下 MIPS Little 指令集,并手动让 IDA 识别指令和函数。逆向文件可知基本上就是在验证一个内存中自带的密码字符串是否合法。 - 由于里面一大堆 syscall 我逆不出来到底是怎么 handle 的,我借助动调来理解程序的执行顺序和验证过程。我使用硬件断点
rwatch检测哪里读取了 flag,并在这时在整个内存空间搜索此时的 PC 值。后续就可以通过watch *PC来单步调试其中的指令,或是通过watch *PC==0x???来下断点。不过由于 CPU 是流水线设计,我们能够拿到的 PC 大概率是取指阶段的 PC,其指向的指令会过几轮才发生实际的计算或访存操作。 - 很有意思的是,不管你 VM 再复杂,模拟内存也不过是一个明文大数组,因此我还可以不断检测虚拟的栈上变量。在依靠这个拿到一些常量之后解出了这题。
- 题目基于作者自制的流水线 MIPS CPU,给出了一个基于 verilator 的 stripped 二进制文件,用来运行 CPU。所以这是一道 VM 类型的题目(大雾)。内存模块使用
2025-7-27
- 继续看《HHH》,学习了一些常见的低速 bus 协议(UART、SPI、IIC)。
2025-7-28
- 复习 Cache 机制,讨论项目。
- 拿到了 Intel 10700k 的机器,但两根内存条好像频率和 rank 都不一样!看来不能无脑跑 Blacksmith 了,得先看一看论文和工具代码。
2025-7-29~30
- 台风天,在宿舍里二刷了《降世神通:最后的气宗》第一部。
2025-7-31
- 终于把我的笔记本 fedora 耳机使用给修好了,原来是 pulseaudio 和 pipewrite 这两个音频服务器冲突了导致的问题,我卸载了 pulseaudio 再安装了 pipewrite-pulseaudio 这个 pipewrite 提供的 pulseaudio 兼容插件以后,一切东西都正常工作了!(Intel 我错怪你了)
2025-8
2025-8-1~2
- 休息。
- 乐队排练。
2025-8-3
- 给博客目录添加了限制最大级数的功能。大致只要这样写:
<ul><li>About</li></ul>,就可以在 page 的文件里面指定toc_max_level属性了。所以现在的目录栏位不像原来这么拥挤了(太棒了👍)
2025-8-4~5
接下来一长段时间要专心做项目,不得不放弃一些自由探索的时间了,要把主要的精力放在硬件设计领域。
- 学习了 Ascon-128 算法,是一个基于海绵结构的加密认证(或者哈希)块密码算法,在硬件领域非常适合实现,而且很方便就可以支持抗侧信道的特性。轻量级密码算法Ascon原理详解 - 知乎 这篇文章写得还不错。
2025-8-6
- 给 VSCode 配置了 Vim 插件,而且支持自动输入法切换(这个项目有说明如何开启这个功能),挺好用的。
2025-8-7~10
- 跟着《数字设计原理与实现》又学了一遍 verilog,比以前学得深入得多了,下面是一些笔记:
wire和reg都是 verilog 当中的 net 类型,他们的区别在于wire只能进行 continuous assignment,而reg对应 procedural assignment;换句话说wire在assign语句中被赋值,而reg在always块中被赋值。这种区分有的时候是非常不必要的,因为always除了时序逻辑之外也可以用来表示组合逻辑,而此时它就和wire的assign差不多了。所以 System Verilog 就消灭了这种区分,直接用logic代替wire和reg,这也是 System Verilog 当中推荐的写法。- Verilog 当中除了模块以外,还有
function和task两种子程序。如果是一段需要重复使用的计算代码(比如提取出一串东西中的某些比特组成一个结果),就可以用function来实现,减少代码重复和可读性;如果正在编写 testbench,需要模拟一些行为但不需要返回值(比如模拟一个时钟信号、模拟一次AXI4操作),就可以用task来实现;其他时候都使用 module。 - 在编写 testbench 的时候,还可以使用
initial块(对标always)来模拟一些行为,比如初始化信号、设置初始状态等。initial块只会在仿真开始时执行一次,而always块则会持续执行。 - 有一些常用的内置函数和任务,比如
$display类似于printf、$ffluish在结束前刷新缓冲区、$random生成一个随机数、$time返回当前仿真时间、$stop停止仿真等。 - 简单地了解了一下模拟器模拟 verilog 的原理(其实我之前也读过 verilator 生成的C++代码,但在不了解高层设计的情况下读代码就是会看不到全局的设计):模拟器需要全局维护一个事件队列和时钟,所有的事件(比如时钟上升沿、信号变化)都会被添加到这个队列中,并按照时间顺序执行。在 always block 中的 non-block assignment 中,对变量的修改不会立刻生效,因此它们会被安排到当前时刻的一个 delta delay 之后执行(这个概念非常酷!)。如果模拟器发现自己一直在处理 delta time 的赋值(比如超过1000次),我们就知道电路设计可能得有问题了。了解了模拟器的实现之后,会更加理解 verilog 语言本身中的各种设计,毕竟 verilog 语言的设计初衷就是描述电路行为而非进行电路设计。
- 然而,在使用工具对 verilog 进行综合时,确实有一些需要注意的地方:类似于 if, else 结构的电路可能会被综合成一系列线性的判断逻辑,导致延迟巨大;最好使用
case语句,因为这在硬件上是并行的。loop 语句在综合时会被展开,即每一次循环都会对应一条信号通路。如果不希望循环占用面积过多,需要手动将其变成线性的。在过程块中,如果某个变量没有被完全赋值,综合工具会将其生成为一个 latch,这会影响性能因此最好避免。可以使用default语句来确保所有分支都被赋值。
- 推进一生一芯,中间有一些思考:同步电路比异步电路实现起来更简单的原因是,在复杂的电路中往往需要涉及多个需要时间的计算或处理单元。如果简单地将它们连起来而不进行同步,那么如果上游模块在运算时产生不稳定输出,下游模块会基于这些不稳定输出做计算,从而白白增加了晶体管的状态切换、增加了电路产生意外行为的可能性。
2025-8-11
- 阅读了 OpenC910 的 smart_run SoC 中的
axi_interconnect128模块实现。这个模块把一个 Master 连接到四个 Slave 上:- 对于 AW 通道,它根据地址区间选择对应的 Slave,并记录这个 Slave 的 ID 和地址 pair。
- 对于 W 通道,它根据
wid查找对应的 address,再根据 address 判断属于哪一个 Slave(实现得很蠢) - 对于 B 通道,就是简单地把 Slave 的 Response 转发给上级就行,不过对于多个 Slave 同时发送 Response 的场景简单做了一个带优先级的同步机制。
- 对于 AR 通道,就是简单地处理一下握手(ready、valid 信号),地址什么的都是直接连到 Slave 上的,都没有经过这个中转模块。
- 对于 R 通道,模块对每个 Slave 维护一个状态 read_done,用来使一个 Slave 的连续多条读响应也能够连续地返回至上级。初次以外,这里也像 B 通道一样做了简单的优先级机制。
2025-8-12
- 给思源笔记配置了简单的模板标注功能,教程可以参考 SiYuan 模板基础教程。
- 思源笔记支持使用 Golang 的 html/template 库模板,但和标准的 `` 不同,思源需要使用
.action{code}。 - 写好了模板之后需要放到思源笔记的数据目录中,由于我是使用 flatpak 安装的思源笔记,所以模板目录位于
~/.var/app/org.b3log.siyuan/SiYuan/data/templates/,而不是~/SiYuan。
- 思源笔记支持使用 Golang 的 html/template 库模板,但和标准的 `` 不同,思源需要使用
- 终于,切实地推进了一点项目,并感到之后的部分也没有我想象得那么难了。
2025-8-13
- LLM 告诉我项目可能会涉及多时钟域,所以我学习了 【高级数字电路】跨时钟域/CDC设计方法总结。
- 多时钟域最头疼的问题就是,如果时钟并非是倍数关系,那么输入输出更新时,在各自时钟内的相位差是不确定的。这会导致亚稳态(在接收方处于上升沿更新数据的区间内时,发送方恰好正在更新数据,使得接受方接收不稳定的数据)、数据漏采(慢速接收者采集快信号)、同步失序(发送方的一组信号先后 available,导致接收方先后接收更新)的问题。对于亚稳态,只能通过在路径上增加几个缓冲寄存器来使数据稳定下来(处于亚稳态的寄存器会在一段时间后恢复稳定),但可惜的是这些缓冲寄存器只能使其稳定而不能确保其正确。对于数据漏采,要么采用Open-Loop方法,强行使输出的数据保持多个周期;要么采用Close-Loop方法,使用握手信号来确保数据被接收。对于同步失序,可以使用同步、异步 FIFO 等各种方法,百花齐放(具体看文章细节)。
- 如果时钟分频得到的倍数关系,那么慢速的一方在上升沿时快速的一方肯定也处于上升沿,他们之间只需要简单的握手协议以防止漏采就可以了。
2025-8-14
- 在 一生一芯的AXI协议介绍 中,介绍了握手的死锁和活锁问题。ARM IHI0022 手册 里面对握手涉及的信号进行了规范,以防止锁的出现:
- 对于死锁,在 A3.5 Dependencies between channel handshake signals 中,要求只有数据的接收方能够等待发送方置 valid 信号而置 ready,反之则不行。因此在一生一芯文档的例子中,“master 在等 slave 将 ready 置 1 后, 才将 valid 置 1” 这一行为是不允许的。
- 对于活锁,在 A3.3 中对各个 valid 信号的说明中,都有说明 “VALID must remain asserted until the rising clock edge after the Subordinate asserts the READY signal”,因此例子中 “因为上一个周期握手失败, master 在这个周期将 valid 置 0”这一行为是不允许的。
- 知道了 git 的
stash功能,可以暂存现在没有 staged 的修改,然后使用git stash pop恢复,非常适合临时 checkout 到一个以前的分支、或者在以前的 commit 上对代码做了 fix 想同步到最新 commit 的场景。
2025-8-15
- 在硬件设计领域差分测试真的非常有用,在设计加密引擎的时候可以用波形图快速比对实现是否正确。
- 之前在 RISC-V 峰会和两个哥们聊天,听他们说计算所做了一个内存监听卡,终于给我找到资里料了:HMTT v4.3: The latest HMTT version for DDR4、还有 关于HMTT的声明-包云岗。现在这张卡只能监听并记录总线上的地址信息,还没有实现数据的监听和记录,因此距离被拿来作外挂还是有点远。但是这种设备的存在就说明了也可以有监听数据的设备存在,所以内存加密真的是有场景的!
- Synopsys 家的学习版软件,如果想要在非他们官方支持的系统(RedHat Linux、CentOS)上装,实在是太麻烦了。。。
2025-8-16~17
- 杭州临平大剧院演出
- 沪道馆看 Reol 演出
2025-8-18-20
- 学习 GNOME GTK 编程,写了个简单的市场走势查看软件 demo。推荐阅读这个知乎专栏:死磕 GNOME 编程。
- 学习了 Jujutsu—a version control system 这个新版本控制软件的基础用法,一个很好的教程是 Steve’s Jujutsu Tutorial。
- 发现 Linux 上有
who工具可以列出当前系统上的各种伪终端文件,非常适合在同学使用终端时偷偷连上去,往他的终端里拉屎!
2025-8-21 ~ 9-14
- 放暑假!去了山西旅游,还在家里待了两周休养生息,爽了。
2025-9
2025-9-15
- 重新整理了一下内存加密引擎的整个思路,发现了一个看起来非常有探索价值的想法。(然后在一篇2002年的论文上找到了这个想法)
2025-9-16~17
- 配环境,搭起来了一个 VMWare 虚拟机 CentOS7 系统的仿真环境,用共享文件夹把项目目录共享进去,这样就可以用主机的代码编辑器编辑、虚拟机里的仿真器跑仿真了。同样一个 hello world 的 case,用 verilator 跑花了 4810.42s,用 vcs 只花了 35.152s,两者相比是 136.8 倍的差距!!!感觉可以加速我的开发过程 by 一个很高的系数了。
2025-9-18~25
- 刚刚开学,事情比较多!买了辆电动车(九号A2Z 40,解锁方式特别高级,只要蓝牙连上的情况下坐上车就自动解锁了。感觉可以有时间试试蓝牙中继攻击)、买了学校游泳馆年卡(1500一年还挺贵的,每个教学周游泳2.5次才能回本)等等。
- 加入了 0ops,准备近期先学习基础的内核 PWN 知识。主要是跟着 A3的内核利用基础 进行复现,下面简单记录一下:
- 内核利用的一种基础模式:先在内核态进行提权(执行
commit_creds(init_cred)),然后回到用户态拿shell。 - 在正常通过
int3指令进入内核时(老式系统调用),硬件会在切换到内核栈以后自动 push 一些寄存器上去,包括cs、ss、rflags、rsp、rip等;与之对应,在 iretq 指令返回用户态时,硬件会自动 pop 这些寄存器。通常在内核态执行完提权代码后,可以构造一组栈上的寄存器状态让iretq去返回,这些状态的合法值可以通过在用户态时进行save_status拿到。(另外,现代的系统调用syscall指令就不会把一堆寄存器压栈(甚至都不切换栈),只是把状态保存在寄存器中(RIP->RCX, RFLAGS->R11),因此更轻量、更快;与其对应的是sysret指令。由于sysret依赖的状态控制起来不方便(涉及到很多通用和非通用寄存器,而iretq只需要控制栈就好了),所以一般 PWN 不使用sysret返回用户态)。 - 为了缓解 meltdown 漏洞,现代内核普遍开启了 KPTI 保护,对用户态和内核态分开使用不同的页表,使用户态无法访问内核态的内存空间(反之还是可以的,但是存在 SMEP 和 SMAP 保护)。Linux 内核对于 KPTI 的实现非常巧妙,两张页表的顶层节点在物理内存中是相邻的(内核页表在低地址处、用户页表在高地址处),因此切换页表时只需要将 CR3 寄存器(负责存储页表指针)的第13位取反即可。对于开启了 KPTI 的系统,攻击者想要返回用户态时,必须先切换到用户页表(将 CR3 的第13位取反),然后才能执行
iretq返回用户态,否则会因为页表不对而导致内核 panic。这里需要用到swapgs_restore_regs_and_return_to_usermode作为 gadget,他会帮我们切换页表并执行iretq。具体来说,需要布置出以下这个栈布局:swapgs_restore_regs_and_return_to_usermode + ? // 这里需要一个偏移,逆向找到函数中的 `mov rdi, rsp` 作为 gadget 地址 0 // padding 0 // padding user_shell_addr user_cs user_rflags user_sp user_ss - 有这样一种场景:你已经找到了内核中的漏洞,但无法在内核空间布置你的数据。在古早的linux版本(2021年以前,见 这个commit),可以利用栈上的
pt_regs结构体来布置数据,但已经被修了。ret2dir 是指在用户空间用 mmap 进行喷射,比如喷射 ROP 链,然后在内核态盲狙线性映射区虚拟地址的中后半部分。线性映射区的地址在开启 KASLR 以后也会随机变化,如果开了 KASLR 就需要提前泄漏地址(这个区域和 kernel text 偏移大概应该是需要分开泄漏的?不过我还没有确认过),但没有随机化时就是0xffff888000000000。具体见我 kgadget 的 exp(还没传到网上)。
- 内核利用的一种基础模式:先在内核态进行提权(执行
2025-9-26~28
- 我又研究了一下怎么用 buildroot 搭内核题环境(踩了巨多坑),见 Kernel #0: 环境配置。
2025-9-29
- Dating with liz
2025-9-30
- 了解了一下内存的具体机制(作为PWN手终于补齐了一点相关知识吗)。参考了 这个视频 from Branch Education。
- DDR5 内存条通常在主板上是双通道的(channel),每个通道有两个 DIMM 插槽(slot)。一个通道上除了有两对 32bits 的数据线(共同组成 64bits 的内存读写大小基本单位)(两个 sub-channel)外,还有许多其他的线负责元信息的传递,比如有地址和命令通路的 CA Bus(Address & Command Bus)(指定行、列、bank、bank group、rank、行列选通、写使能)、时钟和同步相关的线、错误报告的线、功耗管理线(PMIC,管理电压调节和功耗)、SPD线(Serial Presence Detect,每一颗 DIMM 都会带 EEPROM 存储芯片负责保存内存条的基础参数,包括大小、频率、时序、厂商、序列号等信息)等。在 DDR5 中,SPD 进化成了 SPD Hub,集成了温度传感器、功耗管理,就类似于一个元数据管理接口了。BadRAM 攻击 就利用了这个 SPD 芯片,通过修改里面的内存大小信息欺骗 CPU 造成 Memory Alias 从而攻破了 TEE。这种修改除了可以进行物理攻击达成外,也可以通过软件攻击:如果内存条的 SPD 芯片没有写保护(厂商没有将其锁定)的话,root 权限用户就可以直接修改 SPD 芯片中的内容。
- DRAM 的底层是电容器,通过充放电来存储数据。多个电容(最小单位,也称为 cell)组成一行(row),多个行组成一个 bank。当我们读写数据时,首先目标行的 wordline 会被激活(行选通),使电容与位线(bitline)间的晶体管导通,这样数据(电压)就会传递出来;在这个过程中,感应放大器(sense amplifier)会检测位线的电压并放大,将整根位线的电压拉高/拉低到标准值,从而顺便完成电容的电荷补充(这也就是刷新的原理)。电容需要定期刷新,利用一些统计学方法可以得到我们应该隔多久刷新一个 bank 的数据(比如 64ms)。一行其实是很大的,一个示例的大小是 8192 bits (2^13),但我们一次只会用到其中的很小一部分(8 bits),这是通过将地址的最低几位作为列地址来实现的(列选通)(其实就是一个多路复用器)。同属于一个 sub-channel 的多个 chip 共享了地址和指令线,但有自己独立的数据线,4 个 8 bits 的数据线共同组成了完整的 32 bits 数据线。另:在上述提到的一些数据中,bank group、bitline、wordline 的数量都会随着世代和总容量的不同产生很大的差异。
2025-10
2025-10-1
- 继续昨天的内存硬件大学习。
- 我们在购买内存条时会看到很多参数,比如频率、时序等。我们看到的频率(比如 DDR5-6000、LPDDR5X-8533MT/s)是每秒传输数据的次数(MT/s,MegaTransfers/s),是内存条工作频率的两倍(这也是 DDR 内存得名由来,其全称是 Double Data Rate,即在时钟的上下沿各传输一次数据)。比如对于 DDR5-6000 内存条,其工作时钟频率就是 3000MHz。有的时候我们看到京东商品页面上写“内存频率 4800MHz”,其实是把单位写错了哈哈。
- 除了频率以外,内存条还会有四个(或三个,比如金士顿的内存条)时序参数,比如 CL40-39-39-77,这四个数字其实描述了内存 bank 内部取数据的延迟,都以时钟周期(cycle)为单位。一个完整的从内存中读写数据,需要经历这些步骤:关闭所有行选通信号,将位线预充电到一半的电压,打开目标行的行选通(并等待位线上的信号稳定),最后从目标 column 中读出数据(或写入数据)。与这些步骤相对应,上述的四个参数,分别表示:
- CAS Latency (CL):从目标 column 读出数据的时间。如果目标 column 和上一次内存访问位于同一行,那么只需要一个 CL 就可以从内存中读出新的数据(这也是内存内部的局部性体现)。
- RAS to CAS Delay (tRCD):从打开行选通信号到可以开始读 column 的时间,或者说等待感应放大器将位线拉到稳定值所需的时间。
- Row Precharge Time (tRP):将位线预充电到一半电压的时间。
- Row Active Time (tRAS):一行被激活后,必须保持至少 tRAS 个周期才允许 Precharge。你可以从这个描述看出这个参数有时候并不是很重要(
- 所以一个完整的未命中内存访问通常需要 tRP + tRCD + CL 个周期的时间,而如果是命中内存访问则只需要 CL 个周期。
- 注意,上述的时间不是说“完成某个操作所需要的时间”,而是“预留给某个操作的时间”——比如 CL40 表示的其实是预留给目标 column 读数据的时间——这就解释了为什么内存可以超频:如果内存芯片的实际性能比标称的性能更好,那么就可以在不影响正确性的前提下缩短这些时间,从而提升内存的频率。然而,如果预留时间太短,就会导致数据没有稳定下来就进入下一阶段操作,导致错误的发生。
- 关于 RowHammer 原理:
- DRAM 本身的原理决定了它会不断漏电——电荷会通过连接到行选通信号的晶体管泄漏到位线上。RowHammer 通过快速地反复激活某一行(hammering),使得该行的 wordline 电压快速改变,通过电场耦合效应使相邻行的 wordline 也产生电压波动,从而导致相邻行电容电荷泄漏得更快,最终造成数据翻转(bit flip)。
- 显然,防止漏电只要多刷新数据就行了,但粗暴地加快刷新速度会使性能和功耗大幅增加,因此更好的方法是只对频繁被访问的行以及其附近行进行刷新,这类防御手段被称为TRR(Target Row Refresh)。不同的内存条厂商都有不同的 TRR 实现方式,且都是闭源实现(毕竟是硬件领域),因此 RowHammer 的攻击者往往会通过实验来反向推测 TRR 的实现方式,从而找到绕过 TRR 的方法。这就是 Phoenix: Rowhammer Attacks on DDR5 with Self-Correcting Synchronization 这篇 S&P 26 论文做的事,(熟悉的)ETH Zurich COMSEC 组大哥们把海力士的 DDR5 内存条打穿了!
2025-10-2
- 给日志目录添加了 Most Recent 功能,可以直达最新日志,方便视奸。
- 乐队排练。
2025-10-3~8
- 在瓦肆ear演出,也算是和水中 spica、hitorie 跨时空同台了。
2025-10-9
- 修改了 Most Recent 功能,现在可以直接跳到最新一天而不是最新一月。
2025-10-10~11
- 推进项目,把消息验证码的计算实现好了。
- 复现了一道内核题,见 Midnight Sun CTF 2025 Final - flop。
- 看了这个视频:自己如何邪修成通讯工程师……,了解了一些用模拟信号传输数字信号的协议。(比如 3G 用的 16-QAM)
- 跟着课件大致了解了一下 WiFi 安全。(前情提要:我跨专业选上了一门无线电安全)
- 远古时期的 WEP 协议使用 40b 密钥的 RC4 流密码,且 IV 只有 24b,非常不安全,可以被轻易攻破。WEP 使用 CRC-32 来校验数据完整性,但 CRC-32 显然并不具备抗篡改能力,攻击者可以轻易算出正确的 CRC 值连同其一起伪造。不过这太远古时期了,我就不深究了。
- 现在我们使用的大部分都是 WPA/WPA2 协议,使用 AES-CCMP 来加密数据,包括了计数器和消息验证码来防止重放和篡改,比以前不知道安全到哪里去了,但也存在漏洞。
- WPA2 有两种工作模式,一种是我们熟悉的输入口令(至少8位)就能连上的模式,称为 PSK(Pre-Shared Key);另一种是企业级模式,使用 802.1X 协议进行认证,称为 EAP(Extensible Authentication Protocol)。EAP 模式需要配合 RADIUS 服务器使用,换句话说需要有一个第三方服务器负责存储用户信息并进行认证。
- PSK 模式下特别容易进行监听,如果攻击者也知道这个 WiFi 的口令,他只需要监听四次握手(在客户端连接 AP 时会进行四次握手来协商加密密钥,且这个过程不涉及公钥密码学是纯对称的!!)就能计算出加密密钥,从而解密所有流量。即使攻击者不知道口令,他也可以通过离线暴力破解的方式来猜测口令(因为四次握手中包含了口令的 hash)。非常期待之后能有机会试试这个攻击!
- 攻击者也可以通过伪造 AP 来诱骗用户连接,从而进行中间人攻击(MITM)。如果 AP 使用的是 PSK 模式,那么攻击者只需要知道口令就能伪造 AP;如果 AP 使用的是 EAP 模式,那么攻击者需要伪造一个 RADIUS 服务器,并且让客户端信任这个服务器(通常是通过安装恶意证书来实现的)。一旦客户端连接上了伪造的 AP,攻击者也就可以为所欲为。
- 由于 WPA2 还是很蠢,所以又有了 WPA3 协议,使用 SAE(Simultaneous Authentication of Equals)来取代 PSK,并且终于使用了类似于 ECDH 的密码学方法来协商密钥。反正就是很安全。
- 除了上述这些以外,还有一种基于公钥基础设施的国内特色无线网络协议 WAPI,其使用的都是国密系列的算法,一般会在特殊行业或者保密的单位当中使用。我看了看我的手机,发现是支持 WAPI 协议的,可能国外买的手机就不支持了。
2025-10-12
- 给电脑超频了下。
2025-10-13~14
- 继续看之前提到的 Phoenix 论文,看了看他们的逆向方法。我的理解是:对于rowhammer攻击,我们可以假设“逆向工程TRR机制对于rowhammer攻击有帮助”,但不能通过硬件逆向得到TRR机制(难度太高);于是我们只能猜测:TRR内部存在一个复杂的状态机,控制采样和主动刷新。我们现在提供一组“普通”的hammer payload,广泛地对各个位置进行hammer。按照我们的假设,只要是状态机,那么一定会存在重复的行为、而且一定会有主动刷新的次数变化。因此,我们可以借助这个普通payload,用完全黑盒的方法测出TRR机制的盲点。为什么TRR会存在这种盲点?其实我们在做实验之前不能完全确定,但是实验结果告诉我们是存在的,因此就不用管到底为什么会存在这种盲点了!
- 看了看 Narrowbeer: A Practical Replay Attack Against the Widevine DRM(USENIX Sec 25),了解了一下什么是 DRM(Digital Rights Management,数字版权管理)。DRM 是一种概念(有点类似 TEE 也是一种概念),用来指代用来防止数字内容盗版的技术。现在的很多流媒体网站(比如国内爱奇艺、国外 Netflix、Youtube等)都有自己的防盗版措施,基本上就是在不可信的信道上保持内容处于加密状态,并且在客户端的安全处再进行解密和播放。当然,客户端这边也不代表安全,毕竟客户端这边非常有可能是一个具有 root 权限的黑客,所以根据客户端能达到的安全级别,DRM 又会划分成不同的 level,提供不同高清程度的视频(一种纵深防御)。比如 Widevine 的 L1 表示客户端支持在 TEE 中解密和播放视频,具有非常高的安全性,所以也会提供最高清的视频;而 L3 就表示客户端是纯软件实现的,安全性很低,所以只能提供标清的视频。Narrowbeer 这篇论文主要从 Widevine L1 软件的证书相关处理入手,发现只要 hook 住随机数生成和时间戳获取的相关函数,就可以让 Widevine 误以为证书是合法且未过期的。感觉这个破解其实应该出现在吾爱破解的精华帖上,不应该出现在 USENIX 上(?)。
- 看了 WireTap 攻击(CCS 25),在 Intel 的服务器 SGX 上恢复得到了 attestation key。主要利用了三点:
- (第一点)基本上所有 TEE 都将物理内存分配的任务交给 hypervisor,因此在不做主动随机化防御的情况下,一个 hypervisor 可以将 TA 的一个变量精确控制到某一个物理地址。(可能需要许多工程上的努力)
- (第二点)部署在至强服务器上的 SGX 和原来的不同,叫做 Scalable SGX,最多支持 512G 内存,这是以取消了完整性树为代价换来的。没了完整性树之后,不存在 ctr 这种东西,因此相同的密文在固定的物理地址上一定会对应一个固定的密文。
- (第三点)攻击者在物理接触计算机时,可以自己嗅探内存总线,监听所有内存读写(包括数据)。在我们的认知中这种设备很贵,但作者仅仅使用 857 美刀就搭出来了一套 DDR4 内存监听系统,说明这种环境完全是一个 homelab 可以做到的。
- attestation 服务使用 Ed25519 进行签名,其中有一步会基于 nonce k 进行椭圆曲线上的标量乘法 \([k]G\)(G 是基点)。在 SGX 软件对 Ed25519 的实现中,标量乘法使用了 booth 编码,k 会被拆成多个 \([-16, 16]\) 范围内的 \(k_i\),由每个 \(k_i\) 计算 \([k_i]G\),然后将这些结果累加起来得到最终结果。由于 \(k_i\) 的范围很小,因此 \([k_i]G\) 可以预先计算好并存储在一个查表中(预计算,precomputing),之后的计算只需要查表即可。
- 在迭代 \(k_i\) 的过程中,有一步是 \(B=Table[\lvert k_i \rvert]\)。攻击者可以将变量 B 控制在物理内存的一个固定位置,然后预先计算出所有可能的
Table[|k_i|]的值与对应的密文,这样就可以通过观察 B 的密文来恢复出每个 \(\lvert k_i\rvert\)!当然,这个过程需要一些工程操作,比如需要在循环每过一次之后就重置一遍内存把 B 从缓存里踢出去,这样才能确保每次更新 B 都会写入到内存中。总之恢复了所有 \(\lvert k_i\rvert\) 以后就能恢复出 k 了(因为是绝对值所以可能需要一点爆破)。 - Intel SGX 没有承认这个攻击,因为他们认为服务器级别的 SGX 应当没有物理接触的风险。我觉得这种攻击方式可以直接迁移到其他没有完整性树校验的各种 TEE 上。
2025-10-15~16
- 推进项目,把数据加解密不一致修好了,继续修 MAC 计算。
- 尝试基于 Liveblocks 和 excalidraw 搭建在线白板,目前刚把 excalidraw 跑起来。
2025-10-17
- 推项目。。。
2025-10-18~19
- 打强网杯线上赛,做了一道 qemu pwn(babybus)。经历颇为曲折,本来马上就要做出来了,但周日下午乐队排练不得不放弃。晚上回实验室打了二十分钟就本地通了,真的气死我了!!!!!
2025-10-20
- 推项目。。。继续修 MAC 计算。
- 看了 Shadows in Cipher Spaces: Exploiting Tweak Repetition in Hardware Memory Encryption 这篇论文(USENIX Sec 25)。
- 作者逆向了中科海光的 C86 架构芯片特有的海光安全加密虚拟化 CSV(China Secure Virtualization)技术。虽然自很久以前开始,AMD 就没有给海光授权指令集了,但是海光还是自己实现了对于 AMD-SEV 系列指令拓展的二进制级别兼容,CSV 的 v1, v2, v3 分别对应 AMD 的 SEV, SEV-ES, SEV-SNP。
- CSV 的内存加密方案存在漏洞,对同一个缓存行(64B)里的四个 block(16B)理应也采用不同的 tweak value(nonce)进行加密,然而 CSV 实现中并没有做到这一点,导致了类似于 AES-ECB 存在的问题。一个是攻击者可以通过被动观察密文,找到明文相同的两个 block;另一个是攻击者可以替换或复制这四个 block 中的任意两个,等同于对明文做了替换和复制。
- 利用这两个原语,攻击者就可以绕过各种校验了。使用观察的原语,攻击者可以确定某个目标软件存在于物理内存的哪一个位置(确定偏移);使用替换的原语,攻击者可以修改代码和数据(GOT 这种函数指针表就非常适合被攻击)。比如说,程序调用了一个做校验的函数,并且依靠返回值去判断是否通过了校验——这时候就可以把校验函数的指针直接替换掉,只要令返回值为 0 即可。又比如,可以在代码内部进行替换攻击(作者为此还基于 angr 写了一个简单的静态分析小工具,判断何种替换比较合法),让一个函数直接返回等等。
- 这个出成一个 CTF 题目应该还挺有意思的!
2025-10-21
- 推进项目,发现现在都跑不完一个 case,但结束的时候波形都挺对的,怀疑是加解密出错了。但这个好像很难看波形搞,把问题留给明天的我。
- 看了 blackhat USA 2017 的一个 talk Breaking the x86 Instruction Set。作者写了一个 x86 的指令 fuzzer,在各种不同厂商的 CPU 上发现了挺多条 undocumented 的指令,最严重的一个可以直接从 Ring3 锁定当前 CPU(一种 DOS 攻击)。作者在写这个 fuzzer 的时候,用了各种奇技淫巧,令人叹为观止。
2025-10-22~23
- 死命推进项目,狂看波形图,终于把最大的一个 case 跑通了,可以继续开发!
2025-10-24
- 去参加了 Geekcon 2025,见到了很多前辈。Geekcon 是表演性质为主的,有些攻击涉及的技术细节很少(威胁模型都没有讲清楚),看着不是很得劲;还有一些过于专业的我也没怎么听懂(比如讲 windows NTFS log 漏洞的俄罗斯哥们和 sakura 讲的 V8 Null 漏洞)。场地是徐汇龙华机场直升机坪,一块很大很开阔的地方,舞台的背后就是浦东的高楼大厦,头顶是蓝天白云,非常非常漂亮。今天哈里森也来了,于是开始怀念大二暑假在期智研究院实习,吃好饭就来这个江边散步聊天的日子了。当时是从外面看直升机坪,现在是从里面看外面的栈道。
- 谷歌安卓红队(Google Android Redteam)的大哥来分享了他们挖掘 Android 蓝牙协议栈漏洞的经验,slide 见 这里。我觉得他们的 methodology 值得参考,把手动审计、动态分析(fuzzing)和静态分析都用上了,但各侧重于不同类型的漏洞。手动审计在 2025 年依然是寻找高复杂性或者重要漏洞的最有效方法,他们一半的漏洞都是审计出来的;尤其是逻辑漏洞、Race Condition 漏洞、涉及多个组件交互的漏洞,这几种必须要审计才能找出来;不过缺点就是需要专业知识、需要很多时间(一次性成本)且不能批量化寻找。动态分析就是一直跑着(跑在谷歌内部的 fuzzing infra 上),他们会根据不同目标选择使用或开发不同的 fuzzer。此外,静态分析(CodeQL 找到了两个漏洞)这边感觉就没啥特别的了,主要就是 OOB 数组访问比较容易分析出来。
- sakura 大佬强调了攻击面选择的重要性,我觉得非常有道理。
2025-10-25~26
- 待在家里看书。
- 借 XCTF Final 一道题学习了一下 Intel VMX 拓展(Virtual Machine eXtension)(参考文章之一),学了一些新的内核调试技巧(比如
add-symbol-file,hbreak)。(但题目没有做出来,不过到最后也没人做出来就是了)
2025-10-27~28
- 看了 RMPocalypse: How a Catch-22 Breaks AMD SEV-SNP 这篇论文(CCS 25)。
- AMD SEV-SNP 中引入的 RMP(Reverse Map Table)是一个非常关键的设计,作为一个反向的页表,记录了每个物理页的属性权限以及对应的 Guest Physical Page 映射。有了这个表,恶意的 hypervisor 就不能写入 PSP(Platform Security Processor)私有的页面和 CVM 私有的页面。RMP 同时也起到保护自己的作用,将自己所在的物理页面标记成 hypervisor 不可写的状态,阻止自己被修改。RMP 也会被缓存到各级缓存和 TLB 中,在鉴权时多数情况下会直接从 TLB 中拿配置而不是访问物理内存中的 RMP 表。(从这个设计可以看出,每次 PSP 对进行 RMP 更新时都应该强制刷新一波所有处理器中的 TLB 数据,才是安全的)
- SEV 是在主机开机以后,由 x86 核通过 MMIO 寄存器的 API 向 PSP 发送指令来启动的,PSP 中的固件(部分源码见 AMD-ASPFW)会初始化 RMP 表,写入自保护条目。在初始化前,hypervisor 是可以自由控制所有的物理内存的;而在初始化结束后,我们期望 RMP 条目生效,禁止 hypervisor 去访问这块内存。然而,初始化并非一个原子的操作,需要时间来完成,因此 PSP 设计上会在初始化 RMP 前打开两道屏障阻止 hypervisor 对 RMP 区域进行写入——一道位于 x86 核内,一道(TMR,Trusted Memory Region)位于内存控制器附近(Data Fabric 上)。在初始化完毕后,这两道屏障会被取消,因为此时已开启自保护的 RMP 对所有 x86 核都开始生效,不再需要额外的保护。
- 作者发现,他只要在初始化 SEV 的时候搞一个循环疯狂写入 RMP,就特么真的能写入 RMP,什么大力出奇迹?只要在此时把 RMP 自保护的条目干掉,整个 RMP 也就可以被干掉了,从而可以完全攻破 SEV-SNP。
- 根据作者的实验和猜测,整个问题是 PSP 对于 x86 核的屏障未生效所导致的。(根据推测,)x86 核在循环写入时,实际上会写入 cache 内部的一个 缓存行;在 RMP初始化完毕、TMR 被关闭后,这个 dirty cache line 被从缓存中踢出,顺利地写入了内存,从而攻破了 RMP。有点竞争条件和时间差的感觉?但条件非常不苛刻以至于这个攻击的成功率很高。
- 这个文章告诉我们涉及缓存、缓存一致性的系统,想做好权限限制也是非常复杂且容易出错的;另外搞安全的就是不能盲信文档,要亲身去确认文档里提到各种安全的设计到底有没有把安全实现落地出来。
2025-10-29~30
- 给项目整理了阶段性的文档,还有一些杂七杂八的事情。
2025-10-31
- 学习了 SLUB 分配器的基础,主要参考 Linux 内核内存管理浅析 III - Slub Allocator。
- Linux 的主要的内存分配系统是 Buddy System,最小的分配单元是页;slub 分配器是小对象的分配系统,和 ptmalloc 的差异是 slub 分配器为分配“某种特定大小”的结构体做了特化。在 ptmalloc 中,所有大小的堆块都处于同一个堆里面,因此有了复杂的堆块寻址和 size 记录机制,需要在每个堆块前面记录 metadata;在 slub 分配器中,一个 slub(对应一个页或多个连续页,或者说一个
folio)只用来分配一种特定大小、甚至一种特定结构体的内存,因此在堆块处不用记录什么 size metadata,也不需要什么复杂的双链表机制,只需要用一个单链表把 freelist 串起来就行了。 - 一个 slub 对应 \(2^n\) 个连续页,对应的
struct slab结构体 复用了folio结构体,因此内核中可以方便地从一个 slub 中对象得到地址计算出其所属的 slab 结构体的地址(比如说借助virt_to_slab)。之所以 slub 分配器的却使用struct slab作为结构体名,是因为本来这套分配器就叫做 slab,现在的 slub 分配器是改进/优化版本的 slab 分配器,所以结构体还是复用了以前的名字。(这个 Robert Love 的 quora 回答 简单地介绍了 slab、slob 和 slub 分配器的不同) - 之前提到 slub 分配器会为某个大小甚至某个特定结构体维护独立的分配器,
kmem_cache结构体 就承担了这个重任。一个kmem_cache用来分配一种特定的对象,struct kmem_cache中就记录了size、object_size、allocflags、ctor(初始化函数)等对象相关信息;同时,kmem_cache也会记录自己的所有 slab 们(以及他们的信息,比如struct kmem_cache_order_objects oo描述了一张 slab 上的对象数量和 slab 的 order),但这些 slab 会分成两部分,一部分是 per-cpu 的(放在kmem_cache_cpu结构体中),另一部分是各种核都可以用的(放在kmem_cache_node结构体中,又分为不同的 node,这里的 node 指的是 NUMA node,见 What is NUMA?)。 kmem_cache_cpu是“快速分配通道”,因为是 per-cpu 的所以支持无锁分配。里面几个关键域包括:freelist指向下一个可用的 object、slab指向所属的 slab 实例、partial是当前 cpu 拥有的半空 slab 组成的链表。当freelist是一个 null ptr,分配器就知道该换一个 slab 了,于是会从partial再找一个;如果partial也空了,那就需要从后备内存池kmem_cache_node拿 slab。kmem_cache_node是一个 node 拥有的后备 slab 池,里面一些关键域包括:list_lock锁、partial和nr_partial记录半空 slab、full记录已满的 slab、nr_slabs记录总 slab 数量等等。- 内核会出厂自带一些
kmem_cache,他们都分为不同的类型(类型 enum 见 这里)。比如分配 flag 为GFP_NORMAL的通用内存池kmalloc-*、用于 DMA 的内存池kmem-dma-*等;cgroups 为了限制资源,也会创建自己的内存池kmalloc-cg-*。通过ls /sys/kernel/slab/可以看到系统上所有活跃的kmem_cache的具体信息、触发一些操作(比如可以用echo 1 > /sys/kernel/slab/dentry/shrink强制释放空闲的 slab),也可以用cat /proc/slabinfo打开汇总的大表格。 kmem_cache复用机制:许多时候内核代码会新建自己的kmem_cache,但如果内核发现可以复用已有的kmem_cache,就会直接将其返回。- 内核中有一些关于 SLUB 的加强,相关配置见 这里。
CONFIG_SLAB_FREELIST_HARDENED会将 freelist 指针变成ptr ^ ptr_addr ^ kmem_cache->random,代码见 这里;CONFIG_SLAB_FREELIST_RANDOM会在初始化 slab 的 freelist 时将顺序打乱(但运行时还是典型的单链表先入先出操作)(说明见 这里);CONFIG_RANDOM_KMALLOC_CACHES(默认不开启)会为同一个类型的对象准备多个kmem_cache,在分配内存时基于代码地址(没错是 code address)选择其中一个kmem_cache进行分配,这样可以让攻击者堆喷难度加强一大截(不仅要选对 size 和 flag,还要喷到目标kmem_cache里去)。
- Linux 的主要的内存分配系统是 Buddy System,最小的分配单元是页;slub 分配器是小对象的分配系统,和 ptmalloc 的差异是 slub 分配器为分配“某种特定大小”的结构体做了特化。在 ptmalloc 中,所有大小的堆块都处于同一个堆里面,因此有了复杂的堆块寻址和 size 记录机制,需要在每个堆块前面记录 metadata;在 slub 分配器中,一个 slub(对应一个页或多个连续页,或者说一个
- 调了调 RWCTF2022 Digging into kernel 这道题,主要参考 Kernel Heap - Arbitrary-Address Allocation。
- 内存分配到某个全局变量(或者多个线程可能同时访问)的时候要注意有没有加锁,这样的 Race Condition 很常见。
- 在内核“堆基址”
page_offset_base + 0x9d000处存放着secondary_startup_64函数的地址,可以用于泄漏出堆基址后泄漏内核基址。 - 内核 UAF -> 任意地址分配比 ptmalloc 简单多了,只需要把
next劫持成想要的地方就行。但需要注意分配器会把目标块的前八个字节当作next指针更新到freelist变量中,因此最好目标块前八字节都是 NULL Byte,这会让分配器去搞一个新的 slab 出来。 - 常见的任意写提权方法是把
modprobe_path变量覆盖成用户恶意脚本的文件系统路径(虽然不能在里面cat flag但可以chmod 777 flag),如果内核编译选项中没有设置CONFIG_BINFMT_MISC=n的话,用户只要执行一个神秘文件头(比如\xff\xff\xff\xff)的文件,就会去调用恶意脚本了。
2025-11
2025-11-01~02
- 买了 stm32 玩,点亮了小灯。
2025-11-03~04
- 看了 Heracles: Chosen Plaintext Attack on AMD SEV-SNP 这篇论文(CCS 25)。
- 在 AMD SEV-SNP 中,攻击者可以读取 CVM 内存数据的密文(之所以有这种设计,应该是为了简化内存读涉及的硬件通路,使性能更好)、可以调用 PSP 提供的 API 去把 CVM 的页移动到另一个位置(这种设计是方便 hypervisor 对物理内存做去碎片化)。因此,攻击者是可以做选择明文攻击,即攻击者能够通过把自己控制的 CVM 页面(明文已知)移动到目标地址处,来使用目标 tweak 值(或者说加密 oracle)加密明文,获得密文。
- 在选择明文攻击的基础上,如果目标密文/明文的状态空间很小,就可以进行字典攻击:预先把所有可能的明文都使用目标加密 oracle 进行加密,得到 密文->明文 的映射字典,这样只需要观察密文并对照,就可以知道对应的明文数据。
- 这篇工作就关注如何缩小明文的状态空间。作者表示有一类数据结构非常适合进行这种选择明文字典攻击:一个个字符读数据的全零 Buffer,结合已有的单步执行 CVM 的攻击(SEV-Step,基本原理就是用 APIC Timer 给 CVM 发中断让它停下来),攻击者可以让程序每次读一个数据就停下来,此时整个 AES block(128bits)只有一个字节未知,可以当场进行爆破;并不断重复这个过程。利用这种方法就可以泄漏 bash、sudo 这种读取输入的程序读取到的数据。
- 还有一种技巧:可以把某段数据一个字节一个字节“顶”到缓存行开头,同样对单字节进行爆破。这有点像想要知道 AES 加密数据的明文具体长度时,观察添加到第几个字符的时候密文多了一个 block(当然,这也取决于 AES padding mode)。
- 除此以外,还有一些状态空间本来就很小的变量,比如计数器(变化规律已知)等,可以直接爆破。
2025-11-11
- 整理了一下强网杯的 babybus writeup,写成了博客:强网杯线上赛 2025 babybus。
- 看了 TDXploit: Novel Techniques for Single-Stepping and Cache Attacks on Intel TDX 这篇论文(USENIX Security 25)。
- 传统的 TEE VM 单步执行都依靠 APIC Timer 的中断注入,Intel TDX 对这种攻击做了防护。在 TDX 系统上,收到中断的 TD(VM)控制流会首先交给 TDX Module(可信模块软件),由它进行处理。TDX Module 会尝试使用两种方法检测单步执行攻击,首先会尝试通过性能计数器去检测上一次 VM Enter 后执行的指令数量,如果过少就认为是单步执行攻击,这个防御相对新,叫做 Instruction-Count SingleStep Defense (ICSSD);如果是没有支持 ICSSD 的系统,TDX Module 会通过时间 + RIP 变化的启发式条件来判断是否可能是单步执行攻击。如果 TDX Module 判定正在遭受攻击,它会控制 TD 执行 k(\(k \in [1, 32]\))步后再返回 VMM,k 由一个 LFSR 生成。
- 这里的问题在于:使用的 LFSR 并非是一个随机数生成器,攻击者如果知道其状态,就可以预测其后续的输出;此外,TDX Module 使用的 LFSR 并不是每个 TD 所独有的,而是一个 core 所运行的所有 TD 都会共用的(也可以说是一个 core 私有的,但这就会有混淆的问题,which 再次提醒我们涉及到多核同步、上下文切换的问题是多么 tricky),因此攻击者完全可以在自己的恶意 TD 帮助下,还原当前 core 的 LFSR 状态,然后等 LFSR roll 到 1 的时候去执行 Victim VM,从而达成“让 TDX Module 帮我单步执行”的攻击效果。这种攻击非常稳定,甚至还可以多步执行,很有意思~
- 这个故事告诉我们,LFSR 这种伪随机数生成器,由于循环的特性,不可避免地非常容易受到攻击。在有条件的情况下(非性能攸关,比如非硬件层面)还是应该使用更好的随机数生成器(RNG,Random Number Generator)。
2025-11-12~13
- 大致了解了 Path ORAM 的工作模式。
- ORAM(Oblivious RAM)是一种防护机制,阻止攻击者通过观察内存访问的模式(pattern)、地址、频次等信息推断出程序的运行状态(也是一种侧信道)。ORAM 的最终目标是让攻击者看不到内存读写的地址、访问频率、访问间数据依赖关系、访问模式(随机访问/顺序访问)、读写种类。
- Path ORAM 是一种经典的(1400 次引用!)ORAM 方案,由位于不可信外部存储的一颗二叉树(用于存储数据)、位于可信存储(称为客户端)的一个 Position Table(用于记录数据的原地址到树上对应叶子的映射,记录叶子编号意味着这个数据 block 可能出现于树根到这片叶子的路径上的任意一个节点中,所以这种方案被称为 Path ORAM)和一个 Stash(用于暂存读来的数据)组成。
- 二叉树上的每个节点都可以保存多个数据 block,因此被称为 Bucket。里面保存的所有数据都是密文,且加密算法是随机化的对称加密模式(带 freshness 机制),被取回后再加密会得到不同的密文。
- 在访问某数据时,首先查 Position Table 得到对应叶节点编号,然后从树中取出一整条路径的数据放到 Stash 中。Stash 中除了保存数据的值,也会记录对应的叶子节点。此时就可以对 Stash 中的对应数据块进行读写了。读写完成后,这个数据 block 就会随机归属到一个新的叶片。写回阶段会一个个读取 Stash 中的数据 block,如果属于刚取出的那条路径,就会贪心地把它放到节点上,从叶片开始。(如果 Stash 中 block 不足会使用 PRNG 生成 dummy block 放进去)
- 加密算法在每次读取写入内存时,都会用不同的 nonce 进行加密,因此攻击者完全不知道写回一整条 path 时里面哪些数据原来就有、哪些数据消失或新增。如果对 Path ORAM 进行监听,攻击者只能观察到每次都是取了一条 Path 出来、放了一条 Path 回去,而且上面的数据都是叽里咕噜不知道什么东西。
- 看了 A New Secure Memory System for Efficient Data Protection and Access Pattern Obfuscation 这篇论文(arxiv 24)。
- Shamir’s Secret Sharing(SSS)是将一个秘密分散成多个小秘密,只有集齐才能解锁大秘密的算法。算法构造利用了高次方程解系数的原理:假设需要将秘密分为 k 份,就可以构造多项式 \(f(x)=s+a_1x+a_2x^2+...+a_{k-1}x^{k-1}\),式中 \(s\) 为秘密,\(a_i\) 为随机数(需要防止攻击者的预测)。然后,算法会生成若干对 \((x, f(x))\) 分发给小秘密持有者,只有集齐其中 k 对后,才能通过插值法解出秘密 s 的值。
- 文章结合了 Path ORAM 的方法以及 SSS 算法,将一个数据块(大秘密)转化成多个小秘密(\((x,f(x))\) pair),作为 Path ORAM 的 data block 分散在树上。由于 ORAM 机制的保护,攻击者无法知道 data block 与具体数据的对应关系,因此也无法进行小秘密的收集与恢复。
- 文章的一个核心创新是用 SSS 实现了数据的完整性保护。对于一个数据块,首先会将其分块变成 \(p_1, p_2, ..., p_W\),然后生成多项式 \(f(x)=p_1+p_2\times x+...+p_W\times x_W+a_1\times x_{W+1}+...+a_{N−W}\times x_N\),式中 \(a_i\) 由一个可信存储的种子(coefficient seeds)和伪随机数生成器生成,需要使攻击者无法预测。由于整个方程有 \(N\) 位,因此至少需要 \(N\) 个点才能还原出所有的系数(数据分块 \(p_i\) 以及派生出来的 \(a_i\))。这些 \(a_i\) 会充当校验 Tag 的作用,如果发现它们并非由 coefficient seeds 派生,说明密文被篡改了。这种构造在密码学中很常见,可以称为校验值嵌入编码结构(integrity-protected encoding)或者 Algebraic Manipulation Detection Codes(AMD codes)。
- 文章并没有详细介绍如何从种子派生出 Tag,但这里又是方案安全性一个比较关键的地方。如果每次 \(a_i\) 不变,传统 TEE 场景的攻击者可以利用选择明文攻击构造大量的全零数据块去恢复出 \(a_i\);如果 \(a_i\) 只和混淆前地址有关,那么攻击会变得困难一些,有点类似前几天看的 Heracles攻击;如果每次 \(a_i\) 都变化,就需要一种机制去记录 freshness 数据,这似乎是一个很困难的问题。
2025-11-14
- 看了谷歌的博客 Private AI Compute advances AI privacy,介绍了谷歌最新推出的Private AI Compute(PAC)的 AI 基础设施框架。这套框架是软硬件结合的安全机制,威胁模型是 Google 自己都不能访问云计算中的用户数据。这种需求在今天是比较关键的,因为用户显然不能在自己的终端设备上运行大模型。
- 整个 AI 计算流涉及四个主体,互相都通过 ATLS 进行连接(这个协议一般是用来保护谷歌内部设施的 RPC 调用的),包括客户端(手机)、前端服务器、Scalable inference pipeline(运行于 CPU Secure enclave 中,负责调度与分发任务)、Scalable model serving(运行在 Hardened TPU platform 中,负责张量计算)。
- CPU 上使用的是 TEE 技术(AMD SEV 系列);TPU(Tensor Processing Unit)上的 hardened TPU platform 机制和传统 TEE 类似,实现了内存逻辑隔离、传统硬件安全防护(可信固件启动)、远端鉴证(Attestation)这些常见机制。Titan 安全芯片会负责安全启动的部分,验证 TPU 上的保护是否开启、固件是否签名等安全要素。这套基础设施是谷歌自己实现的,名为 Titanium,从第六代 Trillium 开始实现了上述这些安全功能。
- 苹果也有过一篇类似的博客 Private Cloud Compute: A new frontier for AI privacy in the cloud,有着相似的威胁模型:保护用户数据不被 Apple 公司的任何员工获取。他们的私有云计算系统命名为Private Cloud Compute (PCC),其中的节点“使用了与 iphone 相同的硬件安全技术”,包括 Secure Enclave 和 Secure Boot。软件上使用“Swift on Server 构建了一个全新的机器学习堆栈,专门用于托管 我们的云端基础模型”。用户(手机客户端上的 Apple Intelligence,经过 PCC 客户端包装)的推理请求会采用非对称的端到端加密直接和“已验证有效且经过加密认证的 PCC 节点”进行通信,即直接使用目标 PCC节点的公钥加密数据,因此也只有目标 PCC 节点才能解密数据。
- 另外还看到了一个该种威胁模型的开源安全框架 GitHub - openpcc/openpcc: An open-source framework for verifiably private AI inference,感觉挺有意思的。
2025-11-15~16
- 整理前几天的阅读笔记。
2025-11-17~18
- 去做了胃镜,休息。
2025-11-19~21
- 学习 gem5,并终于看懂了五个月之前自己写的代码。
2025-11-22~23
- 休息。
2025-11-24
- 对博客主题进行了大改。
- 最近几天想的 idea 又在 02 年的论文中被我找到了,好消息是这次的想法出现且仅出现在这篇论文中,后来大伙似乎就遗忘了这种技术,于是我似乎有一些可乘之机。
- 实验室里好像有毒气,所有今天来过的人都昏昏沉沉还头痛的。
2025-11-25
- 读了 Mole: Breaking GPU TEE with GPU-Embedded MCU 这篇论文(CCS 25)。
- GPU 通常会内置一个 MCU(Micro Control Unit)负责计算任务的分发,这个 MCU 可能是一颗 RISC-V 芯片(How NVIDIA Shipped One Billion RISC-V Cores In 2024),也可能是一颗 Armv7-M 芯片(ARM Mali GPU)。作为一个通用目的处理器(General Purpose Processor),这个 MCU 具有无穷的潜力(指图灵完备),因此是攻击面上的一个重要的点。
- 作者发现,已有的学术 GPU TEE 方案都忽视了 MCU 的固件保护,而主要注重于运行时的数据隔离(比如驱动形式的 GPU TEE 方案会将数据加密送到 Secure Monitor 处再进行解密)。MCU 在初始化时并没有做固件签名校验,因此允许特权级别的攻击者直接修改位于
/lib/firmware目录下的 MCU 固件(二进制形式),达成对 MCU 的完全控制,并继续达成对整个 GPU 上各种数据的控制。 - 这篇文章修复起来似乎不难?只需要对 GPU 固件加上安全启动、固件签名验证机制就行了。这些学术方案没有考虑到这一点也很正常,毕竟涉及到签名的东西就需要硬件厂商协同一起去搞,对于学术工作来说这是 out of scope 的。不过 ARM Mali CPU 居然自己没有做安全启动的校验,这就有点搞笑了。如果 NVIDIA 也没有做这种校验,那算力锁可能就有救了,华强北狂喜。
- 又在装机,今年来已经装了四台了,现在我也是装机老手了(且有过 5 次及以上 RTX 5090 安装经验)。
2025-11-26
- 算是把 XCTF 决赛的 Kim and The Sun 这题大概看懂了。
- 题目实现了一个简单的 hypervisor
svisor,以及一个加载 hypervisor 用的内核模块not_a_rootkit.o。这个内核模块会在自身初始化的时候,捕获当前的 CPU 状态、遍历物理内存标记出当前内核可用的物理页(其实是标记内核已使用的页)、分配 1MB 空间将 hypervisor 的 binary 复制进去、复用当前内核页表(除了最高级页表外)并在其中添加 hypervisor 的映射(映射到 0x69000 虚拟地址处)、关闭中断并切换到新页表(将 CR3 指向自建的页表)、最后跳转到 hypervisor 的入口处。 - 刚刚内核模块收集到的内存使用信息等信息会作为参数传递给 hypervisor。首先,根据内核模块给的信息,将内核中的可用物理页放入临时内存管理器中,并从其中划分出 4MB 作为初始化时使用的临时内存池(称为 scratch 内存),并重新构造一套新页表用于 GPA -> HPA 的映射:建立新的连续物理内存映射并为每个物理页初始化一个
page_t结构体、把这些结构体和 hypervisor 本身也加入新的映射,然后切换到新的页表,初始化 Buddy 内存管理器(此时 hypervisor 自己的kmalloc就可用了!内部和 SLUB 分配器非常类似),初始化新的描述符表。 - 此时,内存映射和内存管理器已经初始化完毕,开始进行功能上的初始化。
svisor初始化分为arch_init和scall_init两个部分,其中arch_init主要是初始化 VMX、注册 VMEXIT handler、配置 APIC Timer;scall_init主要是初始化后续快照使用的内存桶(类似 SLUB 分配器的kmem_cache机制)。最后,内核模块保存的状态会被用于创建一个新的虚拟机,并跳转过去,从而在not_a_rootkit.ko刚刚停下来的地方继续恢复执行。 - hypervisor 在中断 handler 中实现了一个后门,如果指令是一条特殊指令(
0x9ec80f0f)且寄存器满足一些条件(rdx == 0x11451469420 && rcx == 0xC1a110C1a110),就可以进入一个 scall 功能(类似于一个 ioctl,用户将参数放到 cmd 数据类型中通过一个指针传递给 hypervisor)。scall 提供了 vm 的新建激活销毁、以及快照(snapshot)的创建、捕捉、删除、应用、修改等功能。作为一个用户态程序,攻击者可以触发后门,捕捉自己的快照,通过修改其中的关键寄存器值来关闭保护(cr4 &= ~(SMEP_BIT | SMAP_BIT))、达成提权(修改 CS 和 SS)。 - 比赛那天我就是这么打的,然而题目不会这么简单:在物理内存的一个固定地址处,qemu 放置了一个 flag,然而不论是内核还是 hypervisor 都没有把这个 flag 给映射进来(即使是物理内存线性映射空间也没有映射)。在当前虚拟机内,即使拿到了内核权限,也无法冲破二级页表的限制,因此我们还需要提权到 hypervisor 级别,去劫持二级页表。
- 在 scall 功能中存在 Race 漏洞,其中用于保存快照的单向链表
snapshot_list虽然是各个 VM 都可以访问的全局变量,但是没有被锁保护起来,因此可以通过两个 VM 同时调用删除快照功能达成 Race,让一个被删除的快照依然留在链表中,达成 UAF。被删除的快照仍然会停留在snapshot_bucket中,即使 UAF 也做不了什么,因此需要触发kunit_bucket_free中的kunit_bucket_compact操作,将已经全空的页直接释放回 Buddy System。然后再去寻找有什么数据结构适合被劫持。 - 在 VM 初始化的时候,会使用 Buddy Allocater 分配一块空间用于存储 VMCS。注意,VMCS 并不仅仅存储客户 VM 的状态,还会记录主机的状态(即发生 VMEXIT 时将会进入的状态),具体可以参考 Intel® 64 and IA-32 Architectures Software Developer’s Manual Volume 3C: System Programming Guide, Part 3 的 24.5 章 HOST-STATE AREA。看到里面的 RIP 攻击者就应该高兴了,只要 UAF 了 VMCS,就可以把 EXIT handler 劫持成恶意代码,从而达成 hypervisor 级别的代码执行。这样就可以打通这题了,但因为代码量太大我就懒得调了啊哈哈。
- 题目实现了一个简单的 hypervisor
- 实验室里继续排毒气,今天又是大家都头痛的一天。。。
2025-11-27
- 今天我学聪明了,没有待在实验室,呵呵。
- 借助 codex 的力量,将项目推进了一截。AI 还是太有实力了。
2025-11-28~30
- 准备最后一次演出,但演出前一天下午突然发消息来说演出取消了,唉高市早苗。
2025-12
2025-12-1~4
- 在 *0xA 参加了 Blackhat MEA Final,非常非常幸运地拿到了冠军,学到了很多!PWN 部分出题人是 ptr-yudai,出得太好了,他还赛后马上就放了 官方WP。
- agent 的力量!Gemini 神力!Agent 有时候需要跑在 ubuntu 下才能发挥全部的神力,在别的发行版下就不太能自己装一些工具了。同样的 Agent(Codex)和题目,空白桑跑在 ubuntu wsl 下就跑出来了,我在自己的 fedora 下跑就跑不出。
- 两道 pwn 题都和 TCP 的特殊功能有关,比如 OOB。如果使用 VMWare 开 Linux 虚拟机和题目交互的话,需要注意网卡的模式:如果是 NAT 模式,意味着 VMWare 实现的虚拟网卡代码会修改你的 TCP Packet,其中不一定会实现(从我们的比赛经历来看就是没有实现)对 OOB 这种特性的支持(或者说对 TCP 的 URG 标志的支持)。因此,这种场景下需要一个裸机 Linux 或者一个开启了桥接模式的 VMWare 虚拟机,桥接模式下的虚拟机是一台单独的机器,其虚拟网卡不用对也不会对虚拟机发出的数据包进行任何修改。
- 知道了任何 PCI(以及 PCIe)设备想要进行 DMA 操作(或者说在 PCI 总线上进行发送请求的 Master 操作),就需要将其 Command Register 中的 Bus Master Enable (BME) bit 置为一,这是 PCI Spec 以及 PCIe Spec 中硬性规定的。
- 第一次接触了 UEFI PWN。一个是知道了在 Linux 下也有和 UEFI 交互的方式(通过
/sys/firmware/efi/),UEFI 变量可以通过访问/sys/firmware/efi/efivars下的文件或者通过efivar工具进行读取或修改(理应只有特权用户才有权限,但如果配置不好的话就是一个攻击面了)。另一个是大致知道了 UEFI PWN 的场景下的攻击目标:进入管理界面、修改 Linux 启动参数、在启动时直接进 root shell。这道题的官方解法是劫持控制流调用了PlatformBootManagerUnableToboot函数,这个函数会启动 Management 菜单。自己调试的时候发现如果不挂 Linux 盘就可以进 UEFI 菜单,但由于没什么经验,不知道要去看 OVMF 代码找目标。
2025-12-5~7
- 在沙特旅游,拜访了世界之崖。
2025-12-8~10
- 项目这边,在一个 gem5 原型上把 Linux Boot 了,非常好。
2025-12-11~13
- 看了 Exploiting a 13-years old bug on QEMU。QEMU 9.1 以前的版本中, x86-64 的 TCG 引擎在实现
iret和call far时出了岔子(这么复杂的指令集,QEMU 能没出岔子地实现才怪了),没有考虑到它们在用户态下的语义会有所不同,甚至没有考虑到它们在用户态下被调用的情况。在 TCG 引擎的实现代码中,直接调用了cpu_mmu_index_kernel这种为内核态准备的函数。换句话说,即使在用户态下调用iret以及call far,qemu 也会直接以内核(ring 0)权限执行这条指令,导致用户态可以(在已知内核内存地址的情况下)对内核数据进行读写。call far [mem]指令从[mem]里取出一个 (offset, selector) 形式的远指针(long mode 下是 8 字节 offset + 2 字节 selector)(其实就是允许用户同时更改CS段寄存器和rip),把当前的rip和CS等信息压到当前rsp上,并跳转到目标。因此在 QEMU 实现错误的场景下,在跳转前把rsp设置成一个受害者地址,我们就可以往那个地址写入一个rip和CS,其中rip的低位是我们作为一个用户态程序也可以主动去控制的,由此构造一个粗糙的(因为会在后面多写 N 个字节)内核权限任意写原语。iret在内核态用于从中断中返回,此在 2025-9-18~25 中亦有记载。这个指令会从栈上(rsp)取出一些数据放到rip等寄存器中。在漏洞场景下,这条指令可以用来泄漏数据。我们知道在用户态发生异常的时候,硬件会查询IDT表找到目标 handler 地址以及新的栈地址,然后往栈上 push 一些数据(user_ss,user_rsp,rflags,user_cs,user_rip)。在现代开启 KPTI 保护的内核中,内核和用户态会维护两套不同的页表,但这个隔离做得不是那么彻底。x86-64 硬件不会在异常发生时自动切换页表,但又需要这样一个栈存放自动 push 的数据,所以内核不得不维护一个用户态页表也可见的内存页,作为异常发生时用户态页表和内核态页表都可见的共享的栈。在 Linux 的实现中,这个栈名为entry_stack_page:作为一个临时的栈,内核代码会在处理中断时切换到 task stack 上(对应源码)进行实际的中断处理。不过在进行切换前,entry_stack_page上也会保存许多信息,包括在error_entry函数中调用PUSH_AND_CLEAR_REGS保存的大量用户态寄存器信息,以及许多内核指针。(一些相关的源码链接:中断入口,PUSH_REGS宏实现)entry_stack_page的地址应该受到随机化的保护,但由于 qemu TCG 引擎的实现缺陷(没有实现 UMIP 特性),用户态可以随便拿到它的地址,见同作者写的 make cpu-entry-area great again。只需要sgdt [rsp]; mov rax, qword [rsp+2],就可以通过拿到gdt的地址(也即 cpu_entry_area 的地址)来间接计算出entry_stack_page的地址。- 文章的作者用了一个巧妙的 trick:利用
PUSH_REGS操作在entry_stack_page上布置一个合法的iretframe,让rsp指向它并执行iret,此时 qemu 会(错误地)以 ring 0 权限访问这片区域并取出其中的值放入rsp,rip等寄存器中。通过偏移控制,攻击者可以让想要泄漏的数据(内核指针)被当作user_rip字段放入rip中,随后在iret后触发的(在用户态声明实现的)SIGSEGVhandler 中就能直接拿到想要泄漏的数据地址(uc->uc_mcontext.gregs[REG_RIP]字段),从而完成 KASLR 的绕过。
2025-12-18~19
- 给 0CTF 紧急出了一个 RISC-V TEE PWN 题,攻击者需要利用 TA 的漏洞劫持其控制流,然后编写 shellcode 去调用 Host 侧的 ocall 接口 get shell。虽然构思的时候觉得很有意思,但是实际打的时候就只是一个简单的 RISC-V 用户态 PWN 题而已,稍稍有些可惜(出题时间有点紧张)。
2025-12-22
- 读了 Decompiling the Synergy: An Empirical Study of Human–LLM Teaming in Software Reverse Engineering 这篇 NDSS 26 论文。
- 论文研究了非 agent 形式的 LLM 对新手/专家进行逆向漏洞挖掘的帮助(不涉及反混淆)。
- LLM 最擅长的是快速给出一个总结,不擅长对于一个函数深入的研究,最不善于用来做漏洞的寻找。尤其是在识别一些常见又代码量不大的算法时,LLM 非常有实力!一旦涉及到代码量大一些的函数,LLM 就会有些吃力了。但总得来说,遇到一个陌生函数时马上让 LLM 做一个总结总是会有一些帮助。
2025-12-23~24
- 读了 BadAML: Exploiting Legacy Firmware Interfaces to Compromise Confidential Virtual Machines 这篇 CCS 25 论文,我觉得这篇论文的攻击非常非常之好!有些类似于 S&P 25 的 BadRAM,都是利用硬件/固件给上层操作系统提供的接口来进行攻击。
- ACPI 是一个允许操作系统去配置各个主板硬件设备、管理其电源的协议。主板的固件中会携带 ACPI 表,UEFI 程序会将其传递给操作系统,表中记载了硬件拓扑、设备配置、以及一些 AML(ACPI Machine Language)程序。操作系统有着向目标设备的寄存器写入数据进行配置、控制的需求,AML 是一种允许操作系统方便地进行控制的解耦方法,操作系统无需为特定设备实现专用驱动、只需要根据 ACPI 预定义的一些目的(比如调整设备电源等)来调用固件提供的 AML 函数即可,操控逻辑的实验从操作系统解耦出来,交给了主板固件的开发者(这些开发者本来就需要和各种设备打交道)。此外还有一个有趣的设计,AML 是一种字节码,需要操作系统在内部实现一个虚拟机去解释 AML 程序并执行。
- 举个例子,在笔者多年前查询 Windows 上的休眠、睡眠、关机这些状态到底有什么差别的时候,知乎老哥写的科普 就已经介绍了 ACPI。ACPI 协议对整个系统电源管理的睡眠状态做了定义,包括 S0 ~ S5 六个级别,从 S0(正常运转)到 S5(完全关机)渐变。实际上不论是 Windows 还是 Linux,我们想要知道一个电源功能到底会对设备进行什么操作,只需要去看看底层是调用了哪个级别对应的 AML 程序,比如 Windows 上的休眠就对应了 S4(Suspend to Disk),当按下休眠按钮时,如果当前固件支持 S4 睡眠,内核会拿出 ACPI 表中的对应 AML 程序(大概可以称其为 S4 Handler)并执行它。
- 内核会在内核态(Ring 0)执行 AML 程序,这是因为内核天然就会信任固件(UEFI),真要说的话其实固件的权限比内核还高,因为固件是运行在 SMM 模式(也称为 Ring -2)下的。然而在 TEE 场景下,CVM 中的内核其实是不应该这么信任固件的!这一点就写在 TEE 的威胁模型里,但大家并没有在意到 ACPI 协议中的一个隐藏的攻击面。虽然 CVM 在启动的时候会对整个系统(包括固件在内)做 attestation,确保固件提供的 ACPI 表也合法(虽然固件会根据硬件配置不同,比如从 SPD 获取具体有多少内存的信息(此在 2025-9-30 中亦有记载)并动态生成 ACPI 表,但总体来说生成的 ASPI 表不会特别离谱,比如包含恶意代码)。但现代虚拟化场景下,为了支持动态的 VM 配置且无需每次都生成一个不一样的固件 Binary,qemu 等虚拟机软件会选择在 UEFI 固件中(这个也是虚拟机软件自己实现的)加入一个额外的功能,使固件尝试从某个自定义设备去 fetch 动态的 VM 配置。比如 qemu 会通过
fw_cfg向固件注入 ASCI 配置、启动顺序、虚拟机 UUID、SMP 信息、NUMA 信息、甚至是内核/initrd的镜像。注意,TEE 场景下的 qemu 即恶意的 hypervisor,它能够向固件注入 ACPI 表,意味着它可以控制 CVM 内核执行任意的 AML 程序,完全攻破了 TEE 的威胁模型。对于其他虚拟机实现也是类似的:虚拟机软件实现的固件都有注入配置的接口,攻击者从接口中注入恶意的 ACPI 表就可以绕过 Attestation 控制 TEE 内的操作系统内核。TEE 不存在了! - 这个漏洞最直接的修复方式是把虚拟机固件的动态配置注入功能直接删掉,换成每次动态生成携带不同 ACPI 表的固件。但在 TEE 场景下,不同的固件意味着不同的 Attestation 值,导致每跑在一个不同配置的虚拟机上就需要为其维护一个参考 Attestation 值,这也是挺烦的。作者认为已有的几种防御都有一些缺陷,因此提出在内核的 AML 虚拟机中添加 sandbox 的设计,只允许 AML 程序对 MMIO 区域做读写、对 UEFI 固件区域只读,从而阻止 AML 程序劫持内核。他们把 AML 程序的
C-bit关掉(AMD SEV 中的 entrypted bit),从硬件上阻止了 AML 程序访问 CVM 中的关键数据。我觉得这个防御也还不错。
2025-12-25
- Merry Christmas!
2025-12-26~27
- 看了 HEXACON2024 - Caught in the wild, past, present and future by Clem1,来自 Google Threat Analysis Group 的研究员分享了他们抓在野利用 0day 的各种小妙招,还有他们对 0day 利用的一些观察。
- 作为搜索引擎,谷歌维护着全球最大规模的爬虫,因此他们很容易从公共的互联网上找到浏览器 0day 的线索。水坑攻击(Watering Hole)是在目标群体可能会访问的网站上植入利用等待触发的攻击,爬虫如果发现某个网页突然多链接了一个 js 或者奇妙的域名(甚至是
ip:port组合,其中port是 6666 这种怪数字),就可以知道它可能被挂马了。Typosquatting(拼写抢注 / 错别字域名劫持)也是一种类似水坑攻击的手法。在谷歌拿到 js 代码后,由于 exp 往往有一些 helper 函数(比如d2u)、gc 函数(循环 new 一些对象)和浏览器版本检测函数,有时甚至会硬编码一个 binary(文件头很明显),这些特征可以非常有效地识别出 exp 代码。有时攻击者可能会使用 One-time link 分发 exploit,即第一次被访问时给出 exploit,之后返回正常网页,从而隐藏自己;谷歌维护了 pipeline 去遍历网上的这种链接,确保自己比用户先访问它,这样用户就可以被保护(他们也拿到了 exp)。最困难的方式是看 crash,因为 chrome 的 crash 实在是太多了(悲)。由 exp 导致的 crash 有一些非常明显,比如一个奇怪的段错误(如果rip指向0x114514那可能大概率是东亚的黑客)、或者在 GC 时崩溃(在触发漏洞到构建原语的间隙中如果 GC 介入就会因为奇怪的 JS 结构导致崩溃)。如果有两个不同设备的可疑 crash 都源自同一个域名,这个域名可就非常可疑了:他们(和 Project Zero 合作)靠这种方法曝光并破坏了一个西方政府持续九个月的反恐行动,成功拿到了 2022 年的 pwnie 最烂厂商回应奖,成为一大传奇屎诗。哈哈哈。除此以外他们还会从 VirusTotal 等公开的仓库寻找利用等。 - 接下来他们介绍了漏洞的分发:在分发利用前攻击者会通过服务器端指纹(攻击者服务器通过 HTTP 的 flag 等信息)以及客户端指纹(在 js 代码中通过各种 API)收集客户端信息。这方面的 trick 真是很多,比如在服务器端有着 HTTP/2 Fingerprint,在客户端更是有着五花八门的 API,比如有 User-Agent Client Hint API、WebGL(JS 图形库)版本(示例:
WebGL GLSL ES 1.0 (OpenGL ES GLSL ES 1.0 Chromium))和 VENDOR 信息(示例:WebKit)、视频编码支持情况(一些平台会因为证书原因不支持某些编码)、浏览器的平台(示例:Linux armv81)和语言(示例:zh-CN)、甚至目标设备的电量(可以区分移动目标和固定目标)等。这方面的技巧之多令演讲者感到非常呕吐。 - 接下来他们介绍了漏洞的利用。一个典型的面向手机的浏览器漏洞利用链包括以下步骤:渲染器漏洞触发 -> PAC / V8 堆沙盒绕过 -> Chrome 沙盒绕过 -> 权限逃逸 -> 内核保护绕过 -> 控制手机,中间每一步都允许攻击者获取更多设备信息。在浏览器 RCE 领域,公开研究和在野利用的水平非常接近,唯一显著的区别是在野利用往往会加混淆。”Half-day 漏洞” 在利用中很常见,上游的软件(如 v8、linux kernel)修复的漏洞没有及时传播到下游软件(手机厂商自己的浏览器和分发的内核)就会导致一个漏洞利用的时期。有攻击者会尝试将恶意 payload 网页重定向到厂商浏览器打开,从而触发 Half-day 漏洞,因此谷歌将 silent intent 也视作漏洞(不过即使 silent intent 修复后,用户如果在显式的浏览器选择中选择过时的厂商浏览器,还是会触发漏洞)。在 chrome 沙盒逃逸领域,公开研究并不多,但在野利用的手法都神奇地长得差不多(神奇的 0day 工业),都是一个内嵌了
libchopin.so的 blob。在提权领域,厂商 patch 不及时仍然是一个非常严重的问题。(虽然我们总是嘲笑 pixel 是研究专用机,但它 patch 得确实比别人快。) - 后利用(Post-Exploitation)中攻击者需要清除利用痕迹(一大堆 crash 文件之类的),然后去尝试提取各种 App 的文件。现代手机的 App 太多了,攻击者需要一个一个 App 去适配,这个工作量非常之恐怖!所以后利用也是工作量非常大的一个领域。
- 作者认为随着安全行业的
自内卷不断进步,各种缓解措施的部署,未来以手机为目标的完整利用链会越来越少,利用会转向 partial exploit,比如打完浏览器就提取出 cookie 并到此为止。比起浏览器,更有潜力的方向是去打消息应用(如微信):消息应用的漏洞利用虽然不通用,但打完就可以把隐私资料都提取出来了,而不用像传统的浏览器利用链一样需要本地提权以后才能拿到数据。
- 作为搜索引擎,谷歌维护着全球最大规模的爬虫,因此他们很容易从公共的互联网上找到浏览器 0day 的线索。水坑攻击(Watering Hole)是在目标群体可能会访问的网站上植入利用等待触发的攻击,爬虫如果发现某个网页突然多链接了一个 js 或者奇妙的域名(甚至是
- 看了一个 Merry Christmas Day:CVE-2025-14847。希望读者 get 到笑点。
- 一个
decompressData()函数本来应该返回解压后数据的实际长度,但错误地返回了分配的内存空间长度,导致的信息泄漏漏洞。非常轻松写意的漏洞,非常适合节日氛围(我是不是学疯了?)。
- 一个
2025-12-28~29
- 复习信息论。
- 重构了我的博客,使用 Antigravity 与 Gemini 神力。
2025-12-30
- 读了 ropbot: Reimaging Code Reuse Attack Synthesis 这篇 NDSS’26 论文。
- 一个非常强悍的自动化 ROP 链工具,跨架构,而且支持各种奇奇怪怪的 binary(包括 chromium、linux kernel 等等)。
- 整个管线非常合理:第一步是使用 angr 拿到所有 gadget,记录下它们的依赖和 effect,并从中拿出一些一定可用的基础 gadget 作为可用 gadget 初始集。这里的“一定可用”是有明确定义的:增加了栈指针 + 从栈上获取了 PC + 不含条件分支,这样的 gadget 是 “self-contained” 的。第二步是一个大循环:首先维护一个寄存器图,根据现有可用 gadget 来将图上标记为可控,或者添加边来表示攻击者可以从一个寄存器控制另一个寄存器。循环体内部会去遍历那些
not-self-contained的 gadget,如果它们提供了现有 gadget 没有提供的 effect,就尝试将其和现有 gadget 组合成一个 “self-contained” gadget,具体的组合方式见论文细节。第三步就是根据已有能力进行 chain 的构造了。 - 整个过程非常合理,工具能力也很强。虽然还是会有一些极端的 ROP chain 是工具无法搜索到的(这仅仅是我的经验,比如我在一些 RISC ISA 上写过的 ROP Chain,其 stack comsuming 并非为正,但也足够我调
mprotect跑 shellcode 了),但绝大部分场景下工具表现会非常出色,绝对是够用的。论文提到 Google 等公司已经采用 ropbot 来快速验证漏洞的可利用性,帮助开发团队根据风险严重程度调整补丁修复的优先级,非常有用。 - 论文源码仓库(包含复现相关 artifacts):ropbot。工具源码仓库:angrop。
- 看了 Battelle Shmoocon CTF Jump Planner (libC GOT chaining) 这篇博客,用 Call Oriented Programming 绕过了影子栈机制,很有趣。
2026-01
主要在捣鼓期末相关的事。复现了一个 VMWare Workstaion 逃逸漏洞,之后整理整理发一篇博客。
2026-02
2026-02-04
- 最近玩了玩 google/syzkaller,用来 fuzz Linux 内核。Syzkaller 内置了大量 Linux 内核接口(包括系统调用、设备接口如 /dev/kvm、Netlink 接口如 NETLINK_XFRM 等)的描述,syz-manager 作为中控管理的角色会启动多个 VM,根据这些描述文件变异生成 corpus,从中取出用户态程序在 VM 内部编译运行,并通过 Linux 为用户态 fuzzer 提供的 KCOV 接口读取覆盖率信息。
- Syzkaller 的描述依赖人工分析和手写,可能不完整,于是 ChatGPT 给我推了 f0rm2l1n 的论文:NLSaber: Enhancing Netlink Family Fuzzing via Automated Syscall Description Generation。Netlink 接口传递的是 TLV 格式(Type, Length, Value)的二进制数据,内核某个子模块的开发者在向用户态提供 Netlink 接口时,会约定好接口需要哪些字段,然后解析发来的二进制数据。读者可以想象成序列化和反序列化。论文对各模块的 Netlink message parsing 部分进行了静态污点分析,通过自动化的方法能更全面地提取出这些模块都通过 Netlink 提供了哪些功能,从而给 kernel fuzzer 提供更多内核接口描述。作者用这些自动生成的描述进行 fuzzing,拿到了 12 个 CVE 编号,其中有五个是可以让攻击者拿到写原语的。作者在 artifacts 中给了其中一个类型混淆漏洞(CVE-2025-22056)的 提权 exp。
- 京东獬豸实验室也为这个 CVE 写过一篇博客:Netfilter Tunnel 之殇:CVE-2025-22056。程序员希望计算
某结构体指针 = 起始指针 + 偏移,写 C 语言的时候没处理好类型转换,搞成了先把起始指针转换成结构体指针再加偏移,即某结构体指针 = (结构体*)起始指针 + 偏移,实际加的偏移是结构体大小 * 偏移,实际得到的结构体指针被偏移,后续造成溢出读写。
2026-02-06
- 看了 Karpathy 去年两月做的面向 AI 啥比的视频 Deep Dive into LLMs like ChatGPT,大致记录一下。
- 模型训练第一步是预训练,从互联网上搜集数据后,将它们变成 token,然后再变成向量(embedding)输入给 Transformer 模型,进行自监督学习。这一步得到的是输入一串 token、输出下一个 token 概率序列的基础模型,还不能对话,可以看作整个互联网知识的一个有损压缩。
- 第二步是使用人工构建的对话示例进行监督学习,让模型学会进行对话。为此会创建一些新的 token 用来格式化对话,比如
<|im_start|>user<|im_sep|>你是一个猫娘<|im_end|>,其中用<>扩起来的就是增加的新 token。模型学会这种格式以后,也就学会了对话。在这一步,我们可以让模型知道一个好的回答是怎样的,也可以让模型知道它自己是谁(加入身份相关的示例对话,当然这也可以放在 system prompt 里)。这一步得到的模型是 SFT(Supervised Fine-Tuning)模型。 - 第三步是让模型学会推理。这里会用到强化学习的方法,让模型对同一个问题输出超多答案,奖励其中正确的答案。Deepseek 在 Nature 上发表的论文 DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning 展示了强化学习的神奇效果,模型居然自己学会了思考,表现为我们能看到的思考链(Chain of Thought, CoT)。对于数学题等需要推理的问题,永远不能认为模型能一下子命中答案,必须给模型足够的“思考时间”(对于模型来说就是 token 数量)才行。
- 不过这里也具体分:对于有确定性标准的领域(如理工科问题),我们可以直接使用模型来判断结果是否正确;但对于不存在标准答案的领域,如审美、幽默这种不可言传的东西,模型本身没办法绝对判断哪个答案是好的,从而也不知道应该给予哪个输出奖励。由于强化学习本身要求判断大量输出的好坏,我们也不能雇一大堆人来完成这个任务。解决方案是基于人类反馈的强化学习(RLHF, Reinforcement Learning from Human Feedback),训练一个额外的模型来模仿人类对某个模型输出的好坏评价,再用这个模型作为奖励进行训练。缺点就是 LLM 聪明到可以学会戏弄奖励模型,用奇怪的回答获得高分,所以 RLHF 不能跑太多轮。
2026-02-07
- 了解了一些 prompt engineering(提示词工程)的手法,参考资料是 CS146S 的课件、Prompt Engineering Guide。其实现在大家用 agent 的时候,基本上不太需要自己去进行提示词工程了,agent 自带 prompt 来 push 自己。但是作为模型使用的底层技术,对于 chat 型任务、调 API 完成的一些特定任务来说,还是需要自己写 prompt 并进行调试的。另外这个东西并不像我之前所想的这么无用。
- 大致可以把提示词工程总结为几个优化方向:把事情交代清楚、引导模型更好地使用推理、给模型提供工具、克服模型缺陷、质量控制与对齐。之所以叫做提示词工程而不是提示词编写,是因为我们不仅在考虑一次性的 chat 任务,更想要让模型跑一些批量、重复的工作,为了这些重复的工作我们需要尝试不同的提示词在效果上的差异。
- “把事情交代清楚” 意味着给模型提供更充分的任务上下文,包括任务描述、背景信息、任务输入输出、甚至是任务步骤。所谓的 Few-shot Prompting(给模型提供若干输入输出的样例)、Meta Prompting(把任务输入输出、处理步骤都提取出来变成抽象的任务描述提交给模型)、Retrieval Augmented Generation(RAG,给模型提供任务相关的背景知识)其实都是朝着这个方向努力。
- “引导模型使用推理” 是让模型解决复杂问题的关键步骤,其原理可以类比人类的问题解决流程,即复杂问题需要提供足够的思考时间,对于大模型而言就是需要提供足够的 token 数量(而不是直接让模型给出答案)。虽然在训练模型的时候就已经有意识地尝试让模型学会先思考后给答案的输出模式,但在提示词工程中我们还是最好手动让模型“step by step”完成任务,相当于显式声明“这是一个复杂任务”,从而保证模型有足够的思考时间。
- “给模型提供工具” 是现在 agent 能力的一大来源,就像给手下提供一台工作电脑来让他自己搜索、完成任务一样。有了工具还需要会使用工具,现在很流行的 agent skills 就是教 agent 如何使用工具(的一种方法,这和在提示词里写上怎么用工具本质上是一样的)。还有一个关键点是要使 LLM 能够自行验证解决方案是否准确:我们在使用 agent 的时候往往会发现,只要让 agent 能够接入自行编译、调试、查看报错、解决问题的循环之中,它就能自己表现地很好。On the Coming Industrialisation of Exploit Generation with LLMs – Sean Heelan’s Blog 也提到了这点:“The agent must have some way to verify its solution. The verifier needs to be accurate, fast and again not involve a human.”,这篇博客非常推荐安全研究者阅读,主要展望了未来的 token 密集型安全研究模式。
- “克服模型缺陷” 就是让 LLM 不要整天幻觉了,要求它引用来源、标注不确定、拒绝编造。幻觉这个缺陷和模型本身的训练过程有关:监督学习让模型学会了自信地回答问题😎。为了防止幻觉(目前的模型在训练时已经采取措施减少幻觉了),我们可以在提示词中强制要求模型先搜索(或者先读代码之类的)。
- “质量控制与对齐” 是模型工程化必不可少的一环,主要解决“失败时怎么办”的问题,比如如何处理空的输入等等。要定义好 fallback,让模型在任何情况下都能 handle 住问题。
2026-02-08
- 写了三天,终于写好了这篇博客:协议的原罪:VMware 虚拟机逃逸漏洞分析(CVE-2023-20869+20870)。
2026-02-24
- 看了 FLIPPYRAM: A Large-Scale Study of Rowhammer Prevalence 这篇论文。作者做了 Rowhammer 的大规模研究,将截至 2024 的工具打包成一个框架,通过 u 盘分发给志愿者,通过这种方法得到了 822 个不同配置的 1006 个数据集。其中有 12.5% 可以触发 bit flip。超过一半系统的失败原因是 DRAM 的地址映射函数没能成功逆向出来,具体原因有工具不稳定、超时、1GB huge page 不可用等。由于论文未包含 ZenHammer: Rowhammer Attacks on AMD Zen-based Platforms 的工具,实际的受害比率应该会更高。如果 APT 级别的攻击者对 Rowhammer 工具做了工程化的努力,完全能够获得更高的攻击成功率。不过论文仅仅关注 bit flip 成功率,后续 exploit 的成功率没有研究。
- 也顺便看了 GPUHammer: Rowhammer Attacks on GPU Memories are Practical 这篇论文。在 GPU 的显存上触发 bit flip,很有意思。现在有很多 GPU 分时租赁的服务,如果攻击者租赁了一块 GPU 并能够 bit flip 攻击,他可能可以对同一块 GPU 上其他用户的模型进行参数的修改,降低或完全破坏服务质量;这个攻击的前提是 GPU 并非独占或分时切换,即同一时间内显存里会存在多个用户程序。论文没有提到的是,目前几种租赁方式中,整卡独占、NVIDIA MIG(Multi-Instance GPU,把一张 GPU 切成多个独立实例,每个实例有固定显存)这两种不太会被 Rowhammer 影响,CUDA 多进程共享和 NVIDIA MPS(Multi-Process Service)由于会复用显存,所以确实会受到攻击。ChatGPT 说现在整卡租赁和 MIG 用得比较多,所以这篇文章的攻击效果还是有限的。
2026-03
2026-03-02
- 仔细学习了一下内存的Interleaving机制。
- 在 CPU 的世界里,内存是一片连续的大数组。但当 CPU 的访存信号抵达内存控制器时,一串物理地址就会被拆分、映射到某个具体内存芯片的某些比特上。Interleaving 是通过修改调整地址的映射,来优化内存访问速度的一种技术。
- 在最简单的映射方案中,一个内存地址会从高位到低位,按顺序分流到不同的路径中(请读者回忆数字逻辑中的 Multiplexer)。内存连接的架构大致是
Memory Controller -> Channel -> DIMM -> Rank -> BankGroup -> Bank -> Row -> Column,所以一个内存地址可以拆分成[MC][Channel][DIMM][Rank][BankGroup][Bank][Row][Column][CacheLine Offset],最终选择到一个字节。 - 举例来说,如果系统中每个 BankGroup 都有 4 个 Bank,那么用于选择 Bank 的位宽就应该是 2。除了 CacheLine Offset(一个 Cache Line 是 64B,需要 8 个位表示偏移)之外,用于选择 Row 和 Column 的位宽比较大。在 DDR5 中,通常一个 bank 会有 64K rows,需要 16 个比特来表示;一个 row 中约有 128 个 Cache Line 大小的 Column,所以需要 7 个比特来表示。其他的分流选项通常只需要一两个 bit,比如 PC 里通常只有两个 Channel、一个 Channel 只有两个 DIMM 插槽。
- 这样朴素的映射方法会带来性能问题。内存访问不是简单的 MUX 导通问题,每次访存时,器件都需要准备时间和善后时间。如果现在 CPU 发出了一连串顺序访存请求(这也是计算机最常见的访存模式),这些请求会全都落在同一个 Bank 上。我们有更好的方法:在一个 Bank 等待的时候,其他的 Bank 可以提供服务。只要我们把连续的访存请求“平摊”到各处,整体性能就会提升,如图所示:
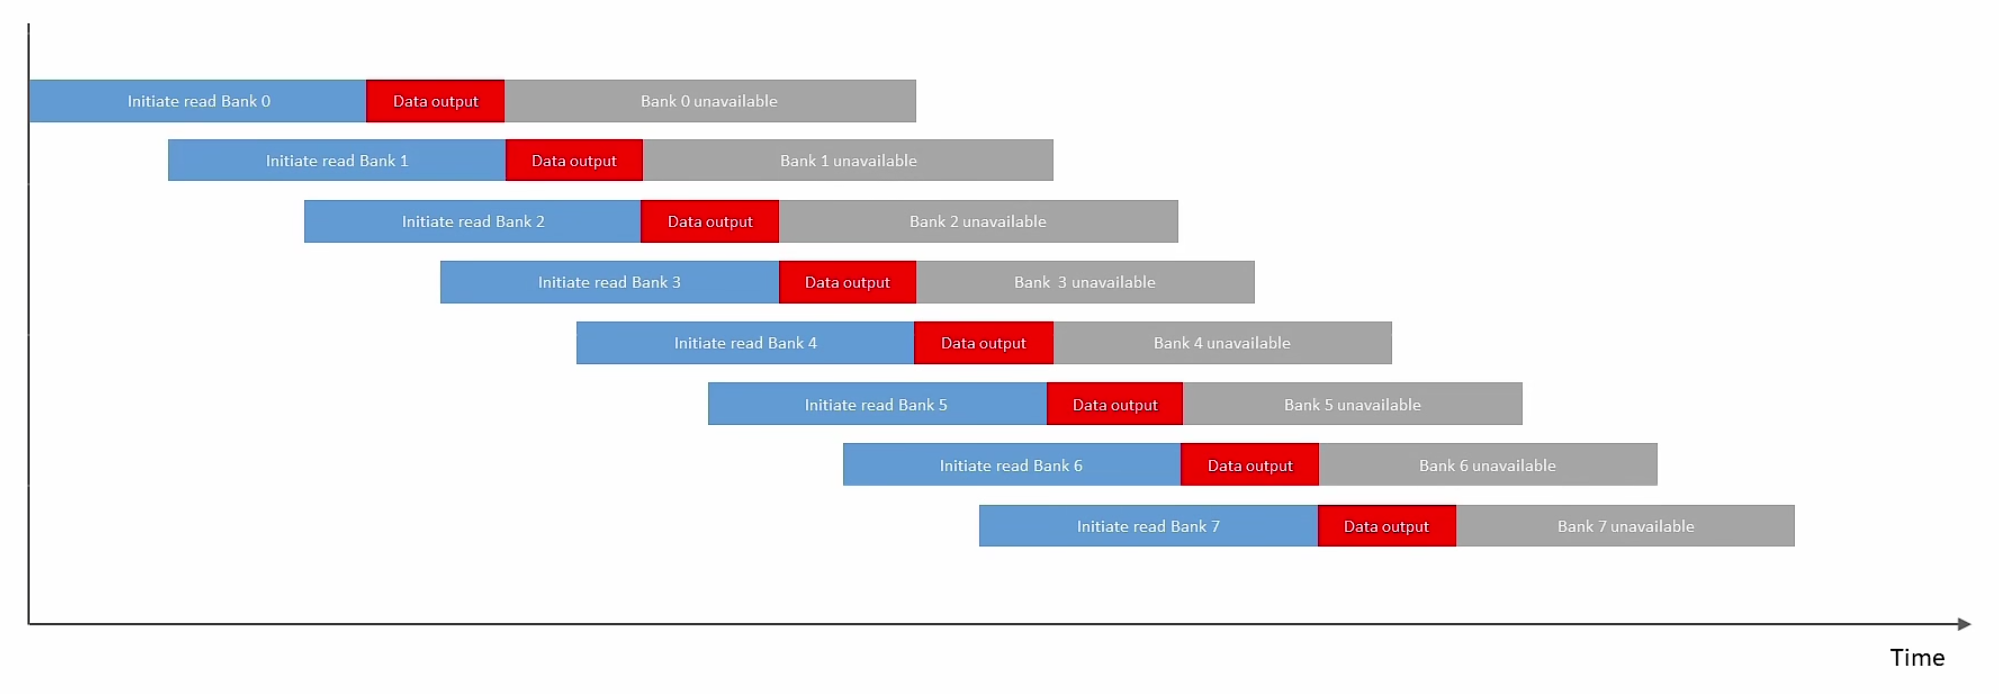 图片来源:DRAM基本工作原理7_内存地址映射_Bilibili
- 除了 Bank 外,Column 和其他层次也存在类似的机制,同样可以通过将连续的请求平摊开来,优化整体的带宽。这种交错访问不同路径的优化就是 Interleaving。
- 然后考虑具体的映射。
- 内存最常见的访问方式是连续访问缓存行,但按照某个其他的固定 stride(间隔)访问也非常非常常见,比如遍历结构体数组时就会以结构体大小为 stride 访问内存。在进行 interleaving 优化时,我们的主要目标是将这种顺序访问分散到不同的地方。在上面这种朴素的分法下,如果访存的 stride 非常硕大、达到了一个 Bank 的大小,那其实就直接满足了“分散访问”的目标,因为每次访存都会分流到不同的 Bank 上。但是一般来说 stride 都比较小,以页(4KB)为 Stride 已经属于大了。我们可以将较低的位设置为 Bank、Channel 这些分流选项的选择位,只要在进行连续访存时翻转了这些选择位,请求就会随着比特翻转而分流到不同的 Bank、Channel 等地方。
- 并不是每种交叉访问都会带来同样的性能提升,浓缩了互联网知识的 GPT 告诉我 Channel 和 Bank 级别的交叉访问最为常用,我没有找到具体的参考资料。至少有一点是可以确认的:Bank level 的 interleaving 非常重要,由于比 Bank 上级的所有分流其实也会导向不同的 Bank,,所以上级的分流同样也是要紧的。
- 但“重要”的选择就那么几个,地址大部分比特还是用来决定 Bank 内的行和列的。如果重要的选择都被放到了低位,如果出现 stride 较大的情况,就会没有重要的比特发生翻转,导致所有的请求又集中在某个 Bank 上了。这种情况下,我们可以用 XOR-based Interleaving 的方法增加 Select bit。比如现在用于选择 Bank 的 bit 位于较低位,我们可以将某个高位用于选择 Column 的与 Bank bit 异或得到最终的 Bank 选择。这样,在我们选中高位比特翻转时,Bank 选择也会翻转,达到交叉访问的效果。
2026-04
2026-04-06
- 了解了一些 iOS 越狱相关知识。
- 安卓越狱的目标基本上就是拿到一个满血的 root shell,但在 iOS 上纵深防御做得好得多,光是提权还不够达成越狱的目标!
- 首先是代码签名绕过。苹果有一套用户态代码的签名验证机制叫做 AMFI(AppleMobileFileIntegrity),每次
execve(以及 page fault 加载新的代码)时,都会触发内核 AMFI 模块(AppleMobileFileIntegrity.kext)对代码进行校验,看看这段代码是否通过某个证书注册过。来自 App Store 的 App 会在安装时将它的 CDHash(SHA256 哈希)注册到本地,自行安装的 App 也会通过企业证书或者开发者证书进行签名……但所有没有注册过、被修改过的代码,在默认策略下都会被拒绝执行。实际的校验会由一个系统进程/usr/libexec/amfid进行,内核模块会向这个 daemon 发起查询请求。为了性能考虑(规避大量的内核用户态切换),在内核侧也会维护一个 TrustCache 存储可信的 CDHash。因此,对于一个越狱工具来说,尤其重要的一点就是绕过或关闭 AMFI,这可以通过攻击amfid或 amfi.kext 来完成。只有在绕过 AMFI 以后,安装第三方应用和实现 tweak(app hook)才具有讨论空间。 - 其次是持久化。在通常的安卓 root 中不存在“越狱持久化”的问题,因为大部分时候越狱本来就是通过厂商开放的接口直接解锁 bootloader(也就是关闭签名校验),刷一个 patch 过的内核镜像到硬盘里。iOS 越狱想要做到持久化,不得不面对一整个不可关闭的可信启动链,从 BootRom 到 iboot(bootloader)到内核再到文件系统中的 System 卷(包括系统 framework、daemon 和 launchd 配置等),每一步都有签名校验保护。古早时期 System 卷没有签名保护,可以有所谓的完美越狱(Untethered Jailbreak),即通过修改 System 卷达成持久化,重启之后越狱状态仍然可以保留;有了 SSV(Signed System Volume)保护后,大多越狱方案都只能做到半完美越狱(Semi-untethered Jailbreak)(重启后需要使用设备上的越狱 App 重新越狱)或半不完美越狱(Semi-tethered Jailbreak)(重启后需要连接电脑越狱)了。
- 再者是内核内部的纵深防护,即 PAC(Pointer Authentication)以及 PPL(Page Protection Layer),使得攻击者极难完全操控内核。PAC 限制了 ROP/JOP、函数指针替换、shellcode 注入这些手法,而 PPL 作为内核中通过硬件拓展隔离出来的一套额外的页表管理系统,也使得攻击者无法通过简单的任意读写原语篡改页表权限。因此,在 iOS 上,“提权”(或者说获取系统服务的权限)比起在内核执行任意代码要简单得多,最近史诗级的 DarkSword 利用链使用了 7 个 0day,最终也只是做到了 LPE(Local Privilege Escape),通过向一些重要的特权服务注入 js payload 来以它们的权限收集和窃取各种敏感信息。对于越狱而言,DarkSword 这些漏洞还不够。
- 苹果的 BootROM 是越狱的一个关键战场,如果能够发现它的漏洞、绕过它对后续启动链的校验,就能和安卓一样刷一个 patch 过的内核进去,也可以做到真正的持久化(BootROM 出厂时就完全固化,无法进行修改或修复)。一个经典的漏洞是 A5-A11 芯片的 checkm8,由 axi0mX 在 2019 年发现:攻击者可以在 DFU 模式下触发 USB 协议栈漏洞,注入 shellcode 去做一些 patch,然后就能得到一个 pwned DFU mode,可以加载任意 ramdisk 了,这里还有他写的 checkm8 exp。当然,BootROM 的防护也是越来越强,它的固件并不像后续阶段的固件一样有着官方公开 公开下载,不过研究员们自己也提取出了 非常多 ROM 固件(里面的 SecureROM 就是 BootROM,只是苹果官方喜欢把它叫做 SecureROM)。
- 最近出的 vphone-cli,实现流程就和越狱有点像,见 Building virtual iPhone using VPHONE600AP component of recently released PCC firmware。
2026-04-10
- 看了 RE//verse 2026: Breaking Encrypted USB Drives with Time-Travel Debugging by Xusheng Li,挺有意思的。这位师傅是 Shellphish 的逆向手,在 Binary Ninja 工作,打通过四次 Flare-On。这个演讲主要介绍了两个东西:一些加密存储实现的漏洞、以及如何在 Binary Ninja 中使用 Time-Travel Debugging(TTD)。
- 联想 Thinkplus FU100 加密 U 盘:根本没加密,拆开后里面是一张存储着明文的 SD 卡。口令(以及指纹)只用来解锁 USB 连接。
- Netac NetacLockFile 加密软件:只加密了三分之一的文件内容(入选最令人费解的程序大赏),且密钥硬编码。
- 联想 Thinkplus TSD303 加密 SSD:在校验用户口令时,SSD 会向软件驱动直接发送口令明文,在软件侧完成口令校验。第一次修复后,变成传输一个加密的口令,但密钥是固定的,还是会在软件侧解锁得到口令明文。关键:口令明文不应该出现在内存中!
- TTD 调试是预先使用工具记录程序的 Trace,然后在这个 Trace 上进行调试(前进或后退),最大的好处是完全不用担心跑飞,而且可以在不重启程序的情况下追踪某个地址的上一次写入(甚至是所有的写入)。记录 Trace 通常有成熟的工具可以做到(比如微软就给 Windows 开发了 WinDbg TTD),Binary Ninja 自己的 debugger 给 WinDbg TTD 内置了支持(就是用 WinDbg TTD 作为后端),用户可以使用美丽的 Binary Ninja UI 来进行 Windows TTD(也支持 Linux,使用 rr 作为后端,使用方法见 文档)